플렉스웍 블로그
AI 업무 전환
AI 에이전트와 자동화를 실제 업무에 적용하는 방법을 다룹니다. 팀에 맞는 AI 도구를 고르고 일하는 흐름을 바꾼 사례를 정리합니다.
인사담당자를 위한 클로드 스킬 ②: 규정 안내·인사 보고·성과평가
클로드 HR 스킬 시리즈 2편 · 인사 운영과 보고 반복되는 사내 규정 문의에 답하고, 월말 인원 현황을 집계하고, 평가 시즌의 문서를 취합하다 보면 판단이 필요한 업무에 쓸 시간이 부족해집니다. 이번 글에서는 Anthropic 공식 Human Resources 플러그인의 규정 안내, 인사 데이터 보고, 성과평가 준비 스킬을 소개합니다. 스킬이 요구하는 자료와 검토 기준을 함께 살펴보고, 각 파일을 자료실에서 개별로 내려받을 수 있도록 구성했습니다. 사내 규정·FAQ 스킬 무료 다운로드 → 인사 데이터 보고 스킬 무료 다운로드 → 성과평가 준비 스킬 무료 다운로드 → 1. policy-lookup: 사내 규정을 근거와 함께 안내하기휴가, 출장비, 재택근무처럼 반복되는 질문에 답할 때는 최신 규정과 적용 대상을 확인해야 합니다. 다른 회사의 관행이나 오래된 문서를 현재 기준처럼 안내해서는 안 됩니다. policy-lookup은 제공된 규정이나 연결된 지식 저장소를 바탕으로 간단한 답변, 세부 설명, 예외, 문의 담당자와 출처를 정리하는 스킬입니다. 공식 지침에는 문서와 해당 구간을 제시하고 규정을 찾지 못하면 추측하지 않도록 명시돼 있습니다. 준비할 자료: 최신 규정, 시행일, 적용 대상, 예외 승인 절차입니다. 여러 버전이 있다면 사용할 최신본을 먼저 정하세요. 첨부한 사내 규정만을 근거로 직원용 FAQ 초안을 만들어줘. 각 답변에 문서명과 근거 조항, 적용 대상, 예외 승인 담당자를 넣어줘. 문서에 없는 내용은 확인되지 않음으로 표시하고 충돌하는 조항은 따로 모아줘. 처음에는 자동 답변을 바로 배포하기보다 반복 문의 열 개 정도를 골라 FAQ 초안을 만들어 볼 수 있습니다. 담당자가 근거 조항과 예외를 확인한 뒤 승인된 답변을 관리하는 방식으로 운영 범위를 정해 보세요. 사내 규정·FAQ 스킬 무료 다운로드 → Anthropic 공식 policy-lookup 스킬 문서 2. people-report: 숫자를 설명 가능한 인사 보고서로 정리하기인원 수를 계산한 뒤에도 무엇이 달라졌고 무엇을 더 확인해야 하는지 설명하는 일이 남습니다. 부서별 숫자의 차이가 곧 특정 원인의 증거가 되는 것도 아닙니다. people-report는 인원 현황, 이직 추이, 조직 건강도 등의 보고서를 준비하는 스킬입니다. 자료를 제공해 요약, 주요 지표, 상세 분석, 후속 확인 사항, 계산 방법을 정리할 수 있습니다. 준비할 자료: 분석 기간, 부서별 인원, 입퇴사일, 지표 정의와 비교 기간 자료입니다. 업무 목적에 불필요한 개인 식별 정보는 제외하고 샘플로 먼저 확인하세요. 익명화한 인원 데이터를 바탕으로 경영진 보고서 초안을 만들어줘. 계산 전에 분석 기간과 지표 정의를 확인해줘. 관찰한 사실과 원인 가설을 구분하고 산식, 누락 자료, 추가 확인 항목을 명시해줘. 휴직자와 계약직을 인원에 포함하는지, 퇴사율의 분모에 어떤 인원을 쓰는지에 따라 결과가 달라질 수 있습니다. 지표 정의를 먼저 맞추고, 계산에 사용한 자료와 누락 항목을 함께 확인하면 보고서 검토가 쉬워집니다. 특정 팀의 퇴사자가 늘었다는 관찰과 그 원인에 대한 가설을 나눠 달라고 요청하세요. 자료에서 확인하지 못한 원인을 단정하는 대신 후속 인터뷰나 추가 데이터로 무엇을 확인할지 정리할 수 있습니다. 인사 데이터 보고 스킬 무료 다운로드 → Anthropic 공식 people-report 스킬 문서 3. performance-review: 평가의 근거와 피드백을 정리하기평가 시즌에는 자기평가와 매니저 리뷰를 취합하고 평가 조정 회의를 준비해야 합니다. 구성원마다 서술 방식이 다르면 검토에 필요한 정보가 빠질 수 있습니다. performance-review는 자기평가, 매니저 평가, 평가 조정 회의 준비 양식을 다룹니다. 목표 달성 근거와 실제 관찰 사례를 정리하고 구체적인 피드백과 개발 계획을 작성하는 데 활용할 수 있습니다. 준비할 자료: 회사의 평가 항목과 등급 정의, 합의한 목표, 실제 성과 기록, 관찰 사례입니다. 공개 양식의 등급 분포나 표현을 회사 제도로 그대로 적용하지 말고 내부 기준으로 바꿔 사용하세요. 우리 회사 평가 기준에 맞춰 매니저 리뷰 초안을 만들어줘. 관찰 사실·성과에 미친 영향·추가 확인 사항·다음 기간 지원 계획을 구분해줘. 제공되지 않은 행동이나 성과는 추가하지 말고 근거가 부족한 판단은 표시해줘. 최종 등급은 사람이 결정하도록 남겨줘. ‘소통이 부족하다’는 표현을 입력했다면 어떤 상황에서 어떤 행동이 있었고 업무에 어떤 영향을 미쳤는지 추가로 정리하도록 요청할 수 있습니다. 근거가 없는 부분은 확인 대상으로 남겨 두고 다음 기간에 필요한 지원을 구체화합니다. 최종 등급과 승진·보상 판단은 책임자가 근거와 맥락을 검토해 결정합니다. AI가 작성한 문장도 실제 기록과 일치하는지 담당자가 확인해야 합니다. 성과평가 준비 스킬 무료 다운로드 → Anthropic 공식 performance-review 스킬 문서 개별 ZIP에는 무엇이 들어 있나요?자료실에서는 소개한 스킬을 각각 내려받을 수 있습니다. 영문 스킬 지침 파일, 한국어 사용 안내, 원본 출처와 라이선스를 함께 담았습니다. 원본에서 참고하는 연결 안내 문서는 필요한 경우 포함했고, 개별 폴더에서 열리도록 참고 경로만 조정했습니다. 개별 사용자 스킬 업로드를 지원하는 Claude 환경에서 ZIP을 등록하거나, Claude Code의 스킬 폴더에 압축을 풀어 사용할 수 있습니다. 전체 HR 플러그인을 쓰려면 Cowork의 플러그인 디렉터리에서 Human Resources를 찾아 설치하세요. 지원 여부와 화면은 계정·관리자 설정에 따라 다릅니다. 다운로드 파일은 업무 지침입니다. HRIS·ATS·메일·캘린더 연결을 설치하거나 실행 권한을 부여하지 않습니다. 외부 도구 없이도 필요한 자료를 직접 제공하는 방식으로 시작할 수 있습니다. 초안을 만드는 일과 검토·실행하는 역할을 함께 정하세요스킬을 회사 업무에 연결할 때는 어떤 자료를 읽고 어디까지 초안을 작성하며 누가 검토할지 정하는 일이 필요합니다. 최신 문서와 지표를 관리할 담당자, 예외를 판단할 사람, 변경 사항을 반영할 절차도 함께 정하세요. 처음에는 회사에서 사용을 승인한 환경에서 익명화한 자료로 시험하고, 반복되는 수정 내용을 기록해 보세요. 정리된 기준은 이후 회사 맞춤 스킬과 업무 흐름을 설계하는 자료가 됩니다. 사내 규정·FAQ 스킬 무료 다운로드 → 인사 데이터 보고 스킬 무료 다운로드 → 성과평가 준비 스킬 무료 다운로드 → 우리 회사의 HR·AI 업무 흐름을 함께 설계할 전문가 상담하기 → 확인일: 2026-10-24. Anthropic 공식 공개 스킬 문서에 근거한 소개입니다. 한국어 요청문은 플렉스웍의 적용 예시이며 실제 고객 성과를 뜻하지 않습니다. 파일 구조와 출처를 점검했으며 실제 HR 시스템 연동과 업무 효과를 검증한 것은 아닙니다. 이전 편: 면접 질문부터 온보딩까지 읽기 →
 플렉스웍
인사담당자를 위한 클로드 스킬 ①: 면접 질문부터 온보딩까지
클로드 HR 스킬 시리즈 1편 · 채용과 입사 준비 다음 채용을 준비할 때 면접 질문지를 처음부터 만들고, 입사자가 생길 때마다 온보딩 목록을 다시 확인하고 있나요? 인사 업무에는 내용은 달라져도 같은 절차를 반복하는 일이 많습니다. 클로드 스킬은 이런 업무의 절차와 참고 자료를 묶어 두는 방식입니다. 관련 업무를 처리할 때 지침을 불러와 활용하므로, 매번 결과물의 형식과 확인 항목을 설명하는 부담을 줄이는 데 활용할 수 있습니다. 이번 글에서는 Anthropic의 공식 Human Resources 플러그인에 공개된 면접 준비와 온보딩 스킬을 소개합니다. 자료실에는 두 스킬을 개별 ZIP으로 등록해 필요한 것만 내려받을 수 있도록 했습니다. 면접 질문·평가표 스킬 무료 다운로드 → 온보딩 계획 스킬 무료 다운로드 → 1. interview-prep: 질문과 평가 기준을 함께 준비하기면접관마다 질문이 다르면 후보자를 같은 기준으로 비교하기 어렵습니다. 평가표가 있어도 점수별로 무엇을 기대하는지 설명돼 있지 않으면 서로 다른 해석이 생깁니다. interview-prep은 직무별 핵심 역량을 정하고, 행동 질문과 상황 질문, 추가 확인 질문을 구성하도록 돕습니다. 면접관별 담당 영역, 점수별 평가 기준, 면접 후 논의 양식도 준비하는 구조입니다. 준비할 자료: 채용 공고, 실제 담당 업무, 입사 후 기대 성과, 기존 면접 질문지입니다. 공고에 적힌 추상적인 표현을 실제 업무 상황으로 풀어 전달하면 초안을 검토하기가 쉬워집니다. 복사해서 써볼 요청 예시첨부한 채용 공고를 바탕으로 면접 계획을 만들어줘. 먼저 기대 성과와 필수 역량에서 모호한 부분을 질문해줘. 답변을 받은 뒤 역량별 질문, 추가 확인 질문, 4단계 평가 기준과 면접관별 담당 영역을 정리해줘. 예를 들어 B2B 마케터를 채용한다면 ‘커뮤니케이션 능력’이라는 항목을 두는 데서 멈추지 않고, 고객이나 영업팀과 어떤 상황에서 합의해야 하는지 설명해 보세요. 이후 질문이 그 상황에서 필요한 판단을 확인하는지 현업 책임자와 함께 검토합니다. AI가 만든 질문을 모두 사용하기보다, 실제로 필요한 역량을 확인할 수 있는 질문을 고르고 표현을 조정하는 과정이 중요합니다. 후보자에게 동일하게 적용할 핵심 질문과 답변에 따라 이어갈 추가 질문도 나눠 둘 수 있습니다. 면접 질문·평가표 스킬 무료 다운로드 → Anthropic 공식 interview-prep 스킬 문서 2. onboarding: 입사 전부터 첫 90일까지 연결하기안내 메일은 보냈지만 계정 신청이 빠져 있거나, 첫날 일정은 준비했지만 첫 달의 기대 역할은 설명하지 못한 경험이 있을 수 있습니다. 온보딩은 일정표와 업무 적응 계획을 함께 확인해야 하는 업무입니다. onboarding은 입사 전 준비, 첫날 일정, 첫 주 활동과 30·60·90일 목표를 연결하는 스킬입니다. 장비와 계정, 버디, 주요 연락처, 직무별 필요한 도구를 계획에 포함하도록 안내합니다. 준비할 자료: 입사일, 직무, 소속 팀, 매니저, 기존 체크리스트, 업무 도구 목록입니다. 기존 양식이 있다면 함께 제공해 회사의 운영 방식이 반영되도록 할 수 있습니다. 복사해서 써볼 요청 예시첨부한 기존 체크리스트를 활용해 신규 입사자의 온보딩 계획을 만들어줘. 입사 전·첫날·첫 주·30일·60일·90일로 나누고 담당자와 완료 시점을 넣어줘. 확인되지 않은 담당자는 확인 필요로 표시해줘. 원격근무 입사자라면 장비 수령과 접속 환경 점검을 입사 전에 배치하고, 첫 주에는 누구에게 어떤 질문을 할 수 있는지 명확하게 안내하는 식으로 조정할 수 있습니다. 담당자 이름이나 계정 권한이 정해지지 않았다면 확인할 항목으로 남깁니다. 생성된 계획은 매니저와 IT 담당자가 검토해 실제 가능한 일정인지 확인하세요. 이후 한 명의 입사자에게 적용하면서 빠진 준비 사항과 과도하게 몰린 일정을 기록하면 다음 온보딩의 기준으로 활용할 수 있습니다. 온보딩 계획 스킬 무료 다운로드 → Anthropic 공식 onboarding 스킬 문서 개별 ZIP에는 무엇이 들어 있나요?자료실에서는 소개한 스킬을 각각 내려받을 수 있습니다. 영문 스킬 지침 파일, 한국어 사용 안내, 원본 출처와 라이선스를 함께 담았습니다. 원본에서 참고하는 연결 안내 문서는 필요한 경우 포함했고, 개별 폴더에서 열리도록 참고 경로만 조정했습니다. 개별 사용자 스킬 업로드를 지원하는 Claude 환경에서 ZIP을 등록하거나, Claude Code의 스킬 폴더에 압축을 풀어 사용할 수 있습니다. 전체 HR 플러그인을 쓰려면 Cowork의 플러그인 디렉터리에서 Human Resources를 찾아 설치하세요. 지원 여부와 화면은 계정·관리자 설정에 따라 다릅니다. 다운로드 파일은 업무 지침입니다. HRIS·ATS·메일·캘린더 연결을 설치하거나 실행 권한을 부여하지 않습니다. 외부 도구 없이도 필요한 자료를 직접 제공하는 방식으로 시작할 수 있습니다. 작은 업무 하나로 시작하고, 회사 기준을 쌓아가세요처음부터 채용과 온보딩 전체를 자동화할 필요는 없습니다. 다음 채용의 면접 질문지 한 벌, 신규 입사자의 첫 주 계획처럼 검토 범위가 분명한 업무부터 시작해 보세요. 채용 판단과 실제 일정·계정 실행은 권한 있는 담당자가 맡습니다. 초안을 수정한 이유를 모으면 회사의 용어, 기대 수준, 누락하기 쉬운 항목이 드러나고 맞춤 스킬에 담을 내용도 구체화됩니다. 다음 편에서는 사내 규정 안내, 인사 보고, 성과평가 준비에 활용할 스킬 3가지를 소개합니다. 면접 질문·평가표 스킬 무료 다운로드 → 온보딩 계획 스킬 무료 다운로드 → 우리 회사의 HR·AI 업무 흐름을 함께 설계할 전문가 상담하기 → 확인일: 2026-10-24. Anthropic 공식 공개 스킬 문서에 근거한 소개입니다. 한국어 요청문은 플렉스웍의 적용 예시이며 실제 고객 성과를 뜻하지 않습니다. 파일 구조와 출처를 점검했으며 실제 HR 시스템 연동과 업무 효과를 검증한 것은 아닙니다. 다음 편: 규정 안내·인사 보고·성과평가 읽기 →
플렉스웍
AI 에이전트에게 일 맡기는 법: 업무를 4가지로 쪼개면 결과가 달라집니다
AI 업무 설계 경험을 프로필에 정리하기 → 핵심 답변: AI 에이전트에 업무를 맡길 때는 목표, 단계, 중간 결과물, 검수 기준의 네 가지를 명시합니다. 단계별 결과를 남기면 오류가 생긴 지점을 찾기 쉽고, 최종 판단과 외부 발송·수치 확인은 사람이 검토할 수 있습니다. "이번 주 경쟁사 동향 정리해 줘." AI 에이전트에게 이렇게 맡겨 본 적이 있나요? 결과물은 그럴듯해 보이지만, 막상 읽어 보면 우리가 알고 싶었던 내용이 아니거나 중간에 멈춰 있는 경우가 많습니다. 대부분의 사람은 여기서 프롬프트를 더 길게 씁니다. 하지만 문제는 문장이 아니라 업무의 모양인 경우가 많습니다. 이 글에서는 에이전트가 제대로 일할 수 있도록 업무를 쪼개는 방법을 예시와 함께 정리합니다. 에이전트는 왜 엉뚱한 결과를 낼까요?사람에게도 "경쟁사 동향 정리해 줘"는 애매한 지시입니다. 경쟁사가 어디인지, 어느 기간인지, 가격을 볼지 채용을 볼지, 결과를 표로 줄지 요약으로 줄지 아무것도 정해져 있지 않습니다. 함께 일한 동료는 맥락으로 빈칸을 채우지만, 에이전트는 추측으로 채웁니다. 그리고 여러 단계를 거치는 일에서는 첫 단계의 작은 추측이 끝까지 불어납니다. 에이전트에게 일을 맡기는 능력은 결국 빈칸을 미리 없애는 능력입니다. 업무를 쪼갤 때 필요한 4가지는 무엇인가요?목표: 이 결과물로 무엇을 결정하나요? 예: 다음 달 가격 정책을 바꿀지 판단합니다. 단계: 어떤 순서로 해야 하나요? 예: 대상 정하기 → 수집 → 분류 → 요약. 중간 결과물: 단계마다 무엇이 남아야 하나요? 예: 링크 목록, 분류표, 3줄 요약. 검수 기준: 무엇을 보고 잘됐다고 판단하나요? 예: 모든 문장에 출처 링크가 있는지 확인합니다. 네 가지 중 가장 자주 빠지는 것은 중간 결과물입니다. 단계마다 눈으로 확인할 수 있는 결과가 있어야, 어느 단계에서 어긋났는지 바로 찾을 수 있습니다. 실제로 쪼개 보면 어떻게 달라질까요?마케터 A 씨가 매주 하는 '경쟁사 동향 정리'를 예로 들어 보겠습니다. (설명을 위한 가상 사례입니다.) Before: 한 줄 지시 이번 주 경쟁사 동향 정리해 줘. After: 5단계로 쪼갠 지시 대상 정하기: 경쟁사 5곳과 확인할 채널(공식 블로그, 보도자료, 채용 공고)을 목록으로 준다. → 중간 결과물: 확인 대상표 수집하기: 최근 7일 안에 올라온 글만 모은다. → 중간 결과물: 링크 목록 분류하기: 가격 / 기능 / 채용 / 마케팅 네 칸으로 나눈다. → 중간 결과물: 분류표 요약하기: 변화 3가지를 고르고 문장마다 근거 링크를 붙인다. → 중간 결과물: 3줄 요약 판단하기 (사람): 우리에게 의미 있는 변화 하나를 고르고 다음 액션을 정한다. 지시가 길어진 것 같지만, 한 번 정리해 두면 매주 그대로 쓸 수 있습니다. 더 중요한 건 결과가 이상할 때 몇 번 단계에서 문제가 생겼는지 바로 보인다는 점입니다. 사람이 꼭 남겨야 하는 단계는 어디인가요?에이전트가 아무리 잘해도 다음 세 가지는 사람이 맡는 편이 안전합니다. 판단: 무엇이 중요한지, 무엇을 버릴지 고르는 일 외부로 나가는 일: 고객에게 보내는 메일, 공개 게시물, 결제 숫자 확인: 보고서에 들어갈 수치와 출처 에이전트는 이 세 지점 앞까지의 일을 줄여 주는 역할입니다. 반복은 에이전트에게, 판단은 사람에게 남기는 것이 기본입니다. 처음 연습할 업무는 어떻게 고를까요?아래 네 가지에 모두 해당하는 업무부터 시작해 보세요. 매주 또는 매일 반복된다 입력 자료가 어디 있는지 명확하다 결과물 형태(표, 요약, 목록)가 정해져 있다 틀려도 바로 고칠 수 있고 피해가 작다 주간 리포트 초안, 회의 후 할 일 정리, 자료 조사 같은 업무가 연습하기 좋습니다. 자주 묻는 질문Q. 프롬프트를 길고 자세하게 쓰면 되지 않나요?길이보다 구조가 중요합니다. 긴 문단 하나보다 목표·단계·중간 결과물·검수 기준이 나뉘어 있는 짧은 지시가 더 안정적입니다. Q. 코딩을 몰라도 할 수 있나요?네. 업무를 쪼개는 일은 코딩보다 업무를 얼마나 잘 아는지에 달려 있습니다. 현업 전문성이 있는 사람일수록 유리합니다. Q. 어떤 도구를 써야 하나요?도구는 바뀌어도 업무를 쪼개는 방법은 그대로 쓸 수 있습니다. 지금 쓰는 도구에서 먼저 연습해 보세요. 쪼개 본 기록은 그 자체로 역량이 됩니다업무를 단계로 나누고, 에이전트에게 맡기고, 결과를 검수한 과정은 기업이 AI 시대 전문가에게 가장 궁금해하는 내용입니다. 어떤 도구를 쓸 줄 아는지보다, 어떤 업무를 어떻게 압축했는지가 더 강한 증거가 됩니다. 오늘 하나를 쪼개 봤다면 그 기록을 남겨 두세요. 업무 문제·산출물·협업 범위와 검수 과정을 정리해 플렉스웍 프로필 초안에 반영해 보세요. 관련 글: AI 자동화 전에 업무 흐름부터 그려야 하는 이유
플렉스웍
AI로 콘텐츠는 늘렸는데, 왜 인바운드 문의 수는 그대로일까?
AI로 콘텐츠는 늘렸는데, 왜 문의는 그대로일까? AI로 주제를 뽑고 초안을 쓰면서 콘텐츠 제작 속도는 빨라졌습니다. 그런데 발행량을 늘려도 문의나 데모 요청이 그대로라면, 다음에는 무엇을 만들어야 할까요? 먼저 확인할 질문이 있습니다. “지금 만드는 콘텐츠는 고객의 어떤 구매 고민을 해결하고 있는가?” 제품의 필요성을 설명하는 글을 다섯 편 더 만들어도, 고객이 망설이는 이유가 “기존 시스템과 연동할 수 있을까?”라면 필요한 답은 여전히 비어 있습니다. 물론 문의에는 유입 규모, 방문자 구성, 제품 수요도 영향을 줍니다. 그중 B2B 마케팅팀이 기존 콘텐츠에서 점검할 수 있는 세 가지를 살펴보겠습니다. 1. 고객이 검토를 멈추는 질문에 답하고 있는가콘텐츠를 주제나 형식으로만 분류하지 말고, 각 콘텐츠가 답하는 고객 질문을 한 문장으로 적어보세요. “이 문제를 지금 해결해야 할까?” “다른 대안과 무엇이 다를까?” “우리 환경에서 도입할 수 있을까?” 같은 질문에 답하는 글만 반복된다면, 아직 다루지 않은 구매 고민이 있는지 확인해야 합니다. 문제의 중요성을 설명하는 콘텐츠는 충분한데 도입 절차에 대한 자료가 없다면, 다음 기획은 그 공백에서 시작할 수 있습니다. 2. 실제 상담에서 공유할 만큼 구체적인가영업팀에 “최근 고객이 반복해서 물은 질문”과 “내부 승인을 위해 요청한 자료”를 물어보세요. 상담 기록이 많다면 AI로 반복 질문을 먼저 묶고, 담당자가 맥락과 우선순위를 확인할 수 있습니다. 이후 기존 콘텐츠가 그 질문에 충분히 답하는지 살펴봅니다. 예를 들어 “기존 도구와 연동되나요?”라는 질문에 “다양한 연동 지원”이라는 문구만으로는 부족할 수 있습니다. 고객에게는 지원 도구, 준비 사항, 담당자가 해야 할 작업이 필요합니다. 관련 내용이 있는지보다, 고객이 그 자료로 판단할 수 있는지가 중요합니다. 설명이 부족하다면 새 글을 쓰기 전에 기존 글을 보완하거나 FAQ로 정리해보세요. 3. 읽은 뒤 다음 행동이 연결되어 있는가모든 콘텐츠가 곧바로 데모 요청으로 이어질 필요는 없습니다. 문제를 파악하는 독자에게는 체크리스트가, 대안을 비교하는 독자에게는 비교 자료가, 도입을 검토하는 독자에게는 상담 안내가 적절할 수 있습니다. 콘텐츠마다 다음 문장을 완성해보세요. “이 글을 읽은 사람은 ______을 판단하기 위해 ______을 확인하면 된다.” 문장을 쓰기 어렵다면 콘텐츠의 목적을 다시 살펴보세요. 연결할 자료가 없다면 그 자료가 다음 제작 후보입니다. 콘텐츠 5개, 고객 질문 3개로 시작하세요최근 발행한 콘텐츠 5개와 상담에서 반복된 구매 질문 3개를 대조해보세요. 빠진 답, 부족한 설명, 끊긴 연결 중 가장 먼저 보완할 것 하나를 고르면 됩니다. 보완 후 확인할 변화도 정해두세요. 연결 자료 클릭, 상담 신청, 영업팀의 자료 활용 여부 등을 살펴보고, 문의 수는 유입량 변화와 함께 확인합니다. 분석과 제작에 투입할 여력이 부족하다면 외부 전문가와 협업할 수도 있습니다. ‘콘텐츠 마케팅’처럼 넓게 맡기기보다 ‘상담 질문 분석과 도입 FAQ 초안 작성’처럼 과업을 구체화하면 필요한 전문성과 산출물이 명확해집니다. AI로 더 많이 만들 수 있게 됐을수록, 무엇에 답할지 정하는 일이 중요합니다. 다음 콘텐츠 회의에서는 이렇게 물어보세요. “고객의 구매 검토에 필요한데, 우리가 아직 답하지 못한 질문은 무엇인가요?” 우리 팀에 필요한 전문가 찾기
플렉스웍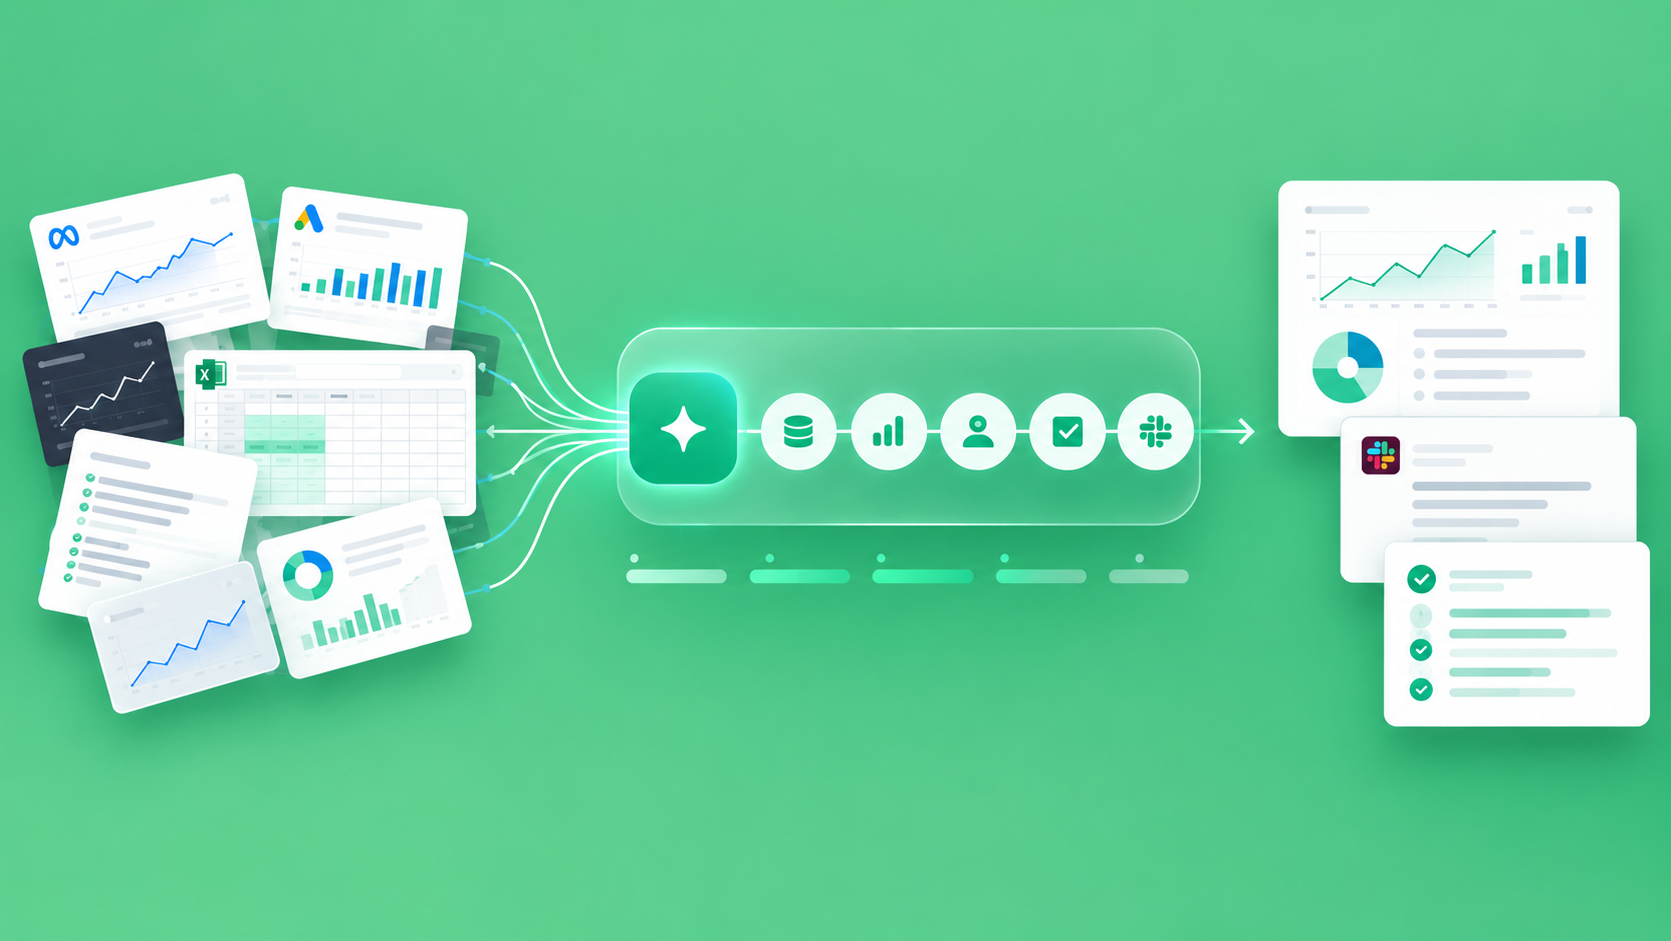
광고 성과 리포트 자동화, 매주 반복하던 일을 Agent 워크플로우로 바꾸는 법
Meta 확인 → Excel 취합 → 분석 → 보고 → Slack 공유. 이 루틴, 낯익지 않나요? 월요일 아침, 마케터 A는 Meta 광고 관리자를 엽니다. 지난주 기간을 선택해 데이터를 내려받고, Excel의 기존 탭을 복사합니다. 열 순서와 기간을 맞춘 뒤 빈 값이 없는지 확인합니다. 캠페인별 변화를 분류하고 보고 문장을 다듬어 Slack에 올립니다. A는 분석할 줄 모르는 사람이 아닙니다. 오히려 업무에 익숙하기 때문에 어긋난 숫자와 이상한 흐름을 빨리 발견합니다. 문제는 그 판단에 도달하기 전까지 데이터를 찾고, 옮기고, 맞추는 일을 매주 되풀이한다는 데 있습니다. 이 업무는 정말 ‘판단 업무’일까요?주간 리포트에는 사람의 판단이 필요합니다. 다만 처음부터 끝까지 모든 단계가 판단 업무인 것은 아닙니다. A가 캠페인별 증감에 색을 칠한다고 해보겠습니다. 그 색을 칠하는 기준이 이미 정해져 있다면, 매번 새롭게 생각해야 하는 일이 아니라 합의된 규칙을 반복 적용하는 일에 가깝습니다. 아래 항목으로 현재 업무를 확인해 보세요. [ ] 매주 또는 매월 정해진 시점에 같은 업무가 시작된다. — 정기성 [ ] 둘 이상의 화면·파일·표에서 데이터를 가져와 한 형식으로 맞춘다. — 데이터 취합 [ ] 목표 대비, 전주 대비, 임계값, 상태값처럼 정해진 기준으로 항목을 나눈다. — 정해진 기준의 분류 [ ] 결과를 공유하기 전에 사람이 누락과 예외를 반복 확인한다. [ ] 최종 보고 형식과 공유 채널이 대부분 정해져 있다. 첫 세 항목이 모두 해당된다면, 보고서를 빨리 쓰는 요령보다 반복 구간을 어떻게 연결할지 먼저 살펴볼 필요가 있습니다. 마지막 두 항목은 사람이 확인할 지점과 예외 처리 방식을 정할 때 쓰는 질문입니다. 자동화 도구를 써도 왜 다음 주에 같은 일을 다시 할까요?A도 Excel 함수와 대시보드를 사용합니다. GPT나 Claude에 CSV를 넣고 요약문을 만들어 본 적도 있습니다. 비정기 분석이나 초안을 만들 때 이런 도구는 분명 유용합니다. 그런데 다음 주 월요일이 되면 A는 지난 대화를 찾고, 새 CSV를 준비하고, 지표의 의미와 원하는 출력 형식을 다시 설명합니다. 답변을 받은 뒤에는 보고서에 옮기고 Slack에 공유해야 합니다. 도구가 부족해서가 아니라 업무의 앞뒤가 연결되지 않았기 때문입니다. 반복의 원인은 ‘설계 부재’에 있습니다. 언제 업무를 시작할지, 어느 데이터에 연결할지, 어떤 규칙으로 분류할지, 오류를 어떤 상태로 남길지, 누가 승인할지, 승인 뒤 무엇을 기록할지가 하나의 흐름으로 정리되지 않은 것입니다. 이 연결이 없으면 좋은 모델을 써도 담당자가 매주 작업을 다시 시작합니다. 단발성 GPT·Claude 사용과 Agent 워크플로우의 차이는 모델의 우열이 아닙니다. 단발성 사용에서는 담당자가 파일을 찾고 프롬프트를 입력해야 업무가 시작됩니다. 대화가 끝나면 실행 성공 여부, 누락, 승인 대기 같은 상태가 다음 주까지 이어지지 않을 수 있습니다. Agent 워크플로우에서는 정해진 시각이나 승인된 데이터 갱신을 시작 신호로 삼습니다. 데이터 연결, 분류 규칙, 예외 상태, 담당자 승인, 후속 기록이 한 흐름 안에 놓입니다. Agent를 도입한다는 말은 챗봇을 하나 더 추가한다는 뜻이 아닙니다. 반복 업무가 매번 같은 조건과 규칙으로 이어지도록 구조를 만드는 일에 가깝습니다. Agent가 들어오면 월요일 아침은 어떻게 달라질까요?가상의 회사가 주간 리포트 흐름을 바꾼다면 핵심은 다음과 같습니다. Meta API → Agent 분석 → 담당자 판단 → Next Action 여기서 ‘Agent 분석’은 성과 변화의 원인을 확정한다는 뜻이 아닙니다. 승인된 데이터를 불러와 정해진 형식으로 맞추고, 합의된 규칙에 따라 검토 순서를 나누며, 이상 신호와 원인 후보를 제시하는 단계입니다. 실제 흐름을 조금 더 자세히 보면 이렇습니다. 정해진 주간 리포트 시각이나 승인된 데이터 갱신이 트리거가 됩니다. Agent는 Meta API를 통해 필요한 기간과 범위의 승인된 지표를 불러옵니다. 지표명, 기간, 단위, 캠페인 식별자를 보고 형식에 맞게 정리합니다. 전주 대비, 목표 대비 등 사전에 합의한 기준으로 검토 우선순위를 분류합니다. 누락이나 급격한 변화를 발견하면 결론을 내리지 않고 ‘확인 필요’ 신호와 근거를 남깁니다. 담당자는 데이터의 완전성과 업무 맥락을 확인하고, 원인 가설과 보고 문구를 승인하거나 수정하거나 보류합니다. 승인된 조치는 Next Action으로 전환되어 담당자, 기한, 이후 확인할 지표와 함께 기록됩니다. 승인된 요약과 링크만 Slack에 공유합니다. 이 구조가 작동하려면 실제 구축 전에 API 접근 권한, 데이터 스키마, 지표 정의, 분류 규칙과 승인자를 정해야 합니다. 인증에 실패하면 보고서를 억지로 만들지 않고 연결 확인 요청을 남겨야 합니다. 데이터 일부가 비어 있다면 정상 결과와 섞어 확정하지 않고 검토 대기로 분리해야 합니다. 담당자가 승인하지 않은 예산 변경이나 최종 공유도 진행하지 않습니다. Agent는 만능 자동화가 아닙니다. 잘 설계된 Agent는 오류와 예외를 감추지 않고 사람이 확인할 수 있는 상태로 드러냅니다. 무엇을 Agent에 맡기고, 무엇을 사람이 결정해야 할까요?월요일 아침의 A는 더 이상 빈 Excel에서 보고서를 조립하는 것으로 업무를 시작하지 않습니다. Agent가 준비한 검토 화면에서 누락 경고, 주요 변화, 분류 근거를 먼저 봅니다. 그리고 “왜 이런 변화가 생겼는가”, “무엇을 바꿀 것인가”에 집중합니다. 그렇다면 A의 일이 사라진 걸까요? 그렇지 않습니다. A가 하던 일 가운데 찾고, 옮기고, 맞추는 일이 Agent 쪽으로 이동하고, 책임 있는 판단이 업무의 앞쪽에 놓인 것입니다. Agent에 맡길 수 있는 반복은 다음과 같습니다. 정해진 시점에 승인된 데이터를 호출하는 일 지표명, 기간, 단위를 보고 형식에 맞추는 일 합의된 기준에 따라 검토 우선순위를 나누는 일 누락과 이상 신호 후보를 표시하는 일 보고 초안과 검토 항목을 준비하는 일 승인된 후속 행동을 기록하고 공유하는 일 사람에게 남겨야 할 판단은 분명합니다. 성과 변화의 실제 원인을 해석하는 일 시장 상황, 프로모션, 소재 맥락을 함께 보는 일 예산을 유지하거나 변경하거나 중단할지 결정하는 일 어떤 메시지와 소재를 선택할지 정하는 일 팀 리더와 관련 부서의 우선순위와 위험을 조율하는 일 기존 기준을 바꾸거나 예외를 승인하는 일 원칙은 간단합니다. 반복은 Agent, 판단은 사람. Agent가 검토 가능한 상태를 만들고, 사람은 결과에 책임을 지는 결정을 내립니다. Before와 After의 업무 흐름은 무엇이 다를까요?Before의 A는 업무가 시작된 뒤 각 화면에 접속합니다. 파일을 내려받아 열을 맞추고, 누락과 기간 오류를 찾습니다. 기준표와 지난 보고서를 다시 확인해 상태를 분류한 뒤 문장을 작성합니다. 리더의 수정 의견이 오면 문서에 다시 반영하고 Slack에 올립니다. 후속 조치는 별도 메시지나 A의 기억에 남기도 합니다. After에서는 보고 시각 전에 정해진 트리거가 데이터 수집과 정규화를 시작합니다. 실패, 누락, 이상 신호는 근거와 함께 검토 대기로 모입니다. A는 준비된 비교와 분류 근거를 확인한 뒤 원인을 해석하고 예산, 메시지, 우선순위를 승인하거나 수정합니다. 승인된 결과는 Next Action으로 이어지고, 담당자와 기한, 이후 확인할 지표가 남습니다. 최종 요약과 링크는 승인 뒤 Slack에 공유됩니다. 다음 실행에서는 이전 상태와 끝나지 않은 조치도 다시 확인할 수 있습니다. 달라지는 것은 막연한 ‘속도’만이 아닙니다. 업무 시작점이 빈 Excel에서 검토 가능한 상태로 바뀝니다. 오류를 최종 문서 작성 중 발견하는 대신 수집·정리 단계에서 별도 상태로 확인합니다. 리더는 완성 문장 전체를 되돌려 보기보다 판단이 필요한 항목을 중심으로 검토합니다. 후속 조치는 대화 속에 흩어지지 않고 담당자, 기한, 확인 지표와 연결됩니다. A는 데이터 운반보다 원인 해석과 실행 우선순위에 집중합니다. 이 변화가 저절로 생기는 것은 아닙니다. 트리거와 데이터 연결만 설정해 놓고 승인 규칙과 오류 상태를 비워 두면, 담당자는 결과 전체를 다시 검사하게 됩니다. Agent의 범위를 정할 때 정상 흐름보다 실패했을 때 멈추는 조건을 먼저 적어두는 편이 좋습니다. 우리 업무도 Agent로 바꿀 수 있을까요?모델이나 도구를 고르기 전에 현재 업무를 한 장에 그려보세요. 아래 질문에 답하면 어디까지 Agent에 맡기고 어디부터 사람이 책임질지 구체적으로 정할 수 있습니다. 이 업무는 무엇을 계기로 시작되나요? 필요한 데이터는 어디에 있고 접근 권한은 어떻게 관리되나요? 반복 적용할 수 있는 분류 기준은 무엇인가요? 누락, 오류, 기준 밖 변화는 어떤 상태로 구분해야 하나요? 사람이 반드시 확인하고 승인해야 하는 지점은 어디인가요? 승인 뒤 어떤 Next Action을 누구에게 어떤 형식으로 남겨야 하나요? 다음 실행에서 참고해야 할 이전 상태는 무엇인가요? 답이 모이면 “Agent가 알아서 처리해 주세요”라는 모호한 요청 대신, 수집·분류·검토·승인·공유 중 어디부터 바꿀지 범위를 정할 수 있습니다. 처음부터 모든 단계를 연결할 필요도 없습니다. 기준이 분명하고 오류를 확인하기 쉬운 반복 구간부터 시작해 사람의 승인 지점을 붙이는 방법도 있습니다. Flexwork는 실제 업무 문제를 기준으로 AI 시대형 전문가와 프로젝트·시간제 협업·커뮤니티·전문가 기회를 연결하는 전문가 네트워크입니다. 매주 되풀이되는 보고 업무가 있다면, 도구를 고르기 전에 시작 조건과 데이터 흐름, 분류 기준, 사람의 승인 지점, 후속 행동을 먼저 적어보세요. 어디가 반복이고 어디가 판단인지 구분되면 Agent로 바꿀 범위도 선명해집니다. 우리 업무 Agent로 바꿔보기
플렉스웍
글로벌 조직은 AI와 어떻게 일하고 있는가
더 많은 콘텐츠가 플렉스웍 뉴스레터로 배달됩니다. AI와 함께 일하는 조직들의 실제 워크플로우, HR·인재 이야기를 매주 구독해보세요. 플렉스웍 뉴스레터 구독하기 툴 도입이 아닌, 워크플로우 자체의 재설계Flexwork x 기고만장 웨비나 1부 · 황소흠 Product Designer 발표 정리 “AI 도구는 도입했는데, 왜 일하는 방식은 그대로일까요?” 웨비나 당시 황소흠님이 던진 이 질문에서 이야기가 출발합니다. 핵심 메시지이번 세션의 출발점은 명확합니다. AI 도구를 도입하는 것과, AI를 중심으로 업무 프로세스를 다시 설계하는 것은 전혀 다른 일이라는 것입니다. 많은 조직이 ChatGPT, Gemini, Copilot 같은 도구를 팀에 배포하는 데서 멈춥니다. 하지만 실제로 조직의 생산성과 경쟁력을 바꾸는 건 그다음 단계, 즉 “이 도구가 있다는 전제 하에 우리 업무 프로세스를 어떻게 다시 짤 것인가”라는 질문입니다. 발표는 이 메시지를 하나의 사례 기업을 통해 10개월간의 타임라인으로 풀어냅니다. 사례: 의료기기 인증 스타트업, 영국 메드테크 기업발표에 등장하는 회사는 의료기기 AI 인증 솔루션을 만드는 스타트업입니다. 병원, 의료기기 제조사를 대상으로 규제 인증 절차를 빠르게 통과할 수 있도록 돕는 서비스를 제공하며, 고객사 사례로 Flok Health, Lucida Medical, Floy 등이 소개됩니다. 규제 문서 검토, 인증 일정 관리처럼 원래 사람이 수작업으로 하던 업무를 AI로 구조화하는 것 자체가 이 회사의 사업이기도 합니다. 다만 이 발표에서 정작 흥미로운 지점은 이 회사가 만드는 제품이 아니라, 이 회사 내부의 일하는 방식이었습니다. 이 회사의 프로덕트 팀, 엔지니어링·디자인·프로덕트가 AI 도입 전후로 어떻게 달라졌는지가 발표의 핵심 사례입니다. Before아이디어에서 기능 출시까지, 엔지니어링·디자인·프로덕트가 순차적으로 일하는 구조였습니다. 한 직군이 자기 몫을 끝내야 다음 직군에 바통을 넘기는 방식이었고, 세 직군의 작업 구간이 시간 축 위에서 서로 겹치지 않았습니다. 그만큼 어느 한 단계가 지연되면 전체 리드타임이 그대로 늘어나는 구조였습니다. After같은 세 직군이 병렬적으로, 작업 구간을 서로 겹쳐가며 일하는 구조로 바뀌었습니다. 기능 출시까지 걸리는 시간이 눈에 띄게 단축된 것으로 소개됩니다. 핵심은 인원을 늘린 게 아니라, 순서대로 넘기던 협업 구조 자체를 동시에 진행하는 방식으로 바꿨다는 점입니다. AI를 활용해 각 직군이 다른 직군의 영역까지 일부 커버할 수 있게 되면서, “순서대로 넘기는” 협업이 아니라 “동시에 진행하는” 협업 구조 자체가 바뀌었습니다. 10개월의 도입 타임라인발표는 이 변화를 하나의 이벤트가 아니라 세 단계로 나누어 설명합니다. 2025년 10월 · 도입 시작디자인·프로덕트·의료 심사원·기술 운영팀이 각자 ChatGPT, Gemini, Copilot 같은 범용 AI 도구를 개별적으로 실험했습니다. 2026년 1월 · 과도기직군별로 구체적인 활용법이 자리 잡기 시작하지만, 팀마다 도구 활용 수준의 격차가 뚜렷하게 드러나는 시기였습니다. 2026년 8월 · 안정기범용 도구 활용을 넘어, 팀 고유의 워크플로우와 표준 프로세스로 정착했습니다. 이 타임라인이 시사하는 바는, AI 도입이 한 번의 의사결정이 아니라 최소 6개월에서 10개월가량의 조직적 학습 과정이라는 점입니다. “도입 시작” 시점과 “안정기” 시점의 활용 수준 차이가 크기 때문에, 단기간에 성과를 판단하기보다 단계별로 다른 목표를 설정하는 접근이 필요합니다. 직군별로 다르게 나타난 변화발표는 도입 시작 단계에서 디자인, 프로덕트, 의료 심사원, 기술 운영팀 네 그룹이 각각 다른 방식으로 AI를 실험했다고 설명합니다. 이 중 구체적 사례가 소개된 두 그룹은 다음과 같습니다. 디자인 팀: 산출물 자체가 바뀐 경우디자인 팀은 Figma 기반의 전통적 디자인 워크플로우에서, AI 기반 코드 생성 도구로 넘어갔습니다. Before 단계에서는 화면 단위로 여러 개의 디자인 파일을 만들어 관리했습니다. 디자이너가 화면을 설계해 개발자에게 전달하면, 개발자가 그 설계를 다시 코드로 옮기는 구조였습니다. After 단계에서는 이 방식이 재사용 가능한 UI 컴포넌트 라이브러리로 바뀝니다. 버튼, 인풋, 셀렉트 같은 요소들을 디자이너가 곧바로 “실제 작동하는 코드”로 만들고, “View code” 버튼을 통해 개발팀이 바로 재사용할 수 있는 구조입니다. 즉 디자이너와 개발자 사이에 있던 “전달”이라는 단계 자체가 사라지고, 디자이너가 설계와 동시에 검증까지 하는 쪽으로 역할이 확장된 사례입니다. 기술 운영팀: 반복 업무의 자동화기술 운영팀은 개발 환경 구축, 코드 리뷰, PR(Pull Request) 관리 같은 반복적이고 규칙 기반의 업무를 AI 에이전트에게 위임하는 방향으로 움직였습니다. 실제로 팀에서는 /automate, /review, /split-to-prs 같은 명령어를 표준화해 사용하고 있는데, 이런 명령어들은 개인이 “이럴 땐 이렇게 물어보면 되더라”는 식으로 쌓아온 노하우를 팀 전체가 공유하는 표준 프로세스로 정형화한 것입니다. 개인의 숙련도에 의존하던 작업이, 팀이라면 누구나 재사용할 수 있는 업무 시스템으로 바뀐 셈입니다. 또한 QMS(품질경영시스템) 문서나 감사 증빙 자료를 업로드·검토·승인하는 과정에도 상태 기반 워크플로우가 도입되어, 담당자가 자료를 올리면 “검토 중 → 승인” 단계를 시스템상에서 추적할 수 있게 되었습니다. 규제 산업 특성상 사람이 최종 승인해야 하는 지점은 남겨두되, 그 앞뒤의 업로드·정리·상태 추적은 자동화한 형태입니다. 가장 많은 조직이 놓치는 지점발표에서 가장 강조된 대목은 “AI 툴만 도입”과 “업무 프로세스 재정의”를 구분한 부분입니다. 대다수 조직이 ChatGPT, Gemini, Copilot 같은 도구를 배포하는 단계에서 멈추지만, 실제 변화를 만드는 조직은 여기서 한 단계 더 나아가 작은 단위로라도 업무 프로세스 자체를 다시 정의합니다. 도구를 얹는 것은 개인의 작업 속도를 조금 높여주지만, 일하는 방식을 바꾸는 것은 팀의 협업 구조와 산출물의 질을 바꿉니다. 황소흠님은 이 차이를 “도구를 얹는 것”과 “일하는 방식을 바꾸는 것”의 차이로 표현합니다. 세 가지 시사점이 사례가 모든 글로벌 조직의 표준이라고 할 수는 없습니다. 다만 AI를 단순한 도구가 아니라 업무 시스템의 일부로 활용할 때 어떤 변화가 가능한지를, 개인 → 팀 → 조직 세 층위로 정리해볼 수 있습니다. 개인: AI는 생산성 도구에서 팀의 인프라로 이동합니다. ChatGPT를 잘 쓰는 사람이 생기는 것과, 팀이 /review, /automate 같은 방식으로 AI 활용법 자체를 표준화하는 것은 다른 일입니다. 팀: 직군의 경계보다 업무의 흐름이 중요해집니다. 디자이너가 코드를 이해하고, 기술 운영팀이 반복 업무를 AI에게 넘기면서, 순차적으로 넘기던 협업이 병렬적으로 진행하는 협업으로 바뀝니다. 조직: 결국 필요한 건 ‘AI를 잘 쓰는 사람’보다 ‘AI와 함께 일하는 방식을 설계할 수 있는 사람’입니다. 도구를 얹는 것과 일하는 방식을 바꾸는 것의 차이는, 결국 이 설계를 누가 할 수 있느냐에서 갈립니다. 본 정리본은 Flexwork x 기고만장 웨비나 1부, 황소흠 Product Designer 발표 자료를 바탕으로 작성되었습니다. 사례로 소개된 영국 메드테크 기업은 발표에 인용된 해외 기업 사례이며, 저작권은 원 발표자 및 해당 기업에 있습니다.
플렉스웍
어떻게든 업무가 이어지도록 돕는 AI 인수인계서
어떻게든 업무가 이어지도록 돕는 AI 인수인계서AI와 오래 이야기하다 보면 어느 순간 답이 엉뚱한 방향으로 흐를 때가 있습니다. 앞에서 하지 않기로 한 방법을 다시 말하거나, 이미 끝낸 일을 제안하기도 합니다. 사람도 비슷합니다. 한참 A를 이야기하다가 갑자기 B와 C까지 한꺼번에 이야기하면 중요한 내용을 놓치기 쉽습니다. AI도 한 대화에서 글쓰기, 자료 조사, 일정 정리처럼 서로 다른 일을 계속 맡으면 지금 가장 중요한 일이 무엇인지 찾기 어려워질 수 있습니다. 이럴 때 필요한 것은 더 긴 대화가 아닙니다. 새로운 대화가 일을 바로 이어받을 수 있게 도와주는 AI용 인수인계 문서입니다. 좋은 인수인계는 다음 일을 바로 이어갈 수 있도록, 결정한 내용과 남은 일을 분명하게 정리하는 것입니다. 저는 세 종류의 문서로 일을 이어갑니다저는 AI와 함께 개인 프로젝트를 장기간 진행하고 있습니다. 한 대화에서 모든 작업을 끝낼 수 없기 때문에, 새 채팅 세션이나 다른 AI 에이전트가 일을 이어받을 수 있도록 세 종류의 문서를 사용합니다. 첫째, 로드맵에는 전체 작업의 현재 위치를 적습니다. 무엇을 끝냈고, 무엇이 남았으며, 다음에 어떤 일을 해야 하는지 한곳에서 확인할 수 있습니다. 둘째, 설계 문서에는 무엇을 왜 그렇게 만들기로 했는지 적습니다. 나중에 다른 AI가 작업하더라도 이미 검토한 선택을 이유 없이 되돌리지 않도록 돕습니다. 셋째, 구현 계획 문서에는 어떤 순서로 만들고 어떻게 확인할지 적습니다. 큰 작업을 작은 단계로 나누고, 각 단계가 끝났다고 판단할 기준도 함께 남깁니다. 이 문서들은 제가 사용하는 Superpowers라는 AI 스킬의 도움을 받아 작성하고 있습니다. 또 로드맵을 확인하고 갱신하는 과정을 일정하게 만들기 위해 별도의 roadmap 스킬도 시험하고 있습니다. 아직 테스트 단계이지만, 인수인계 문서는 한 번 쓰고 보관하는 것보다 일이 바뀔 때마다 현재 상태를 고치는 것이 중요하다는 점을 확인하고 있습니다. 같은 작업의 설계 문서와 구현 계획 문서를 함께 관리합니다. 로드맵에서 완료한 작업과 현재 위치, 다음 작업을 함께 확인합니다. 이 구조를 여행에 비유할 수도 있습니다. 로드맵은 지금 있는 곳과 다음 목적지를 알려주는 지도입니다. 설계 문서는 그 목적지를 고른 이유를 설명합니다. 구현 계획 문서는 그곳까지 어떤 순서로 갈지 알려줍니다. AI의 책상도 크기가 정해져 있습니다제가 이렇게 문서를 나눠 쓰는 이유는 AI가 대화 내용을 끝없이 또렷하게 기억할 수 없기 때문입니다. AI가 한 번에 펼쳐 놓고 참고할 수 있는 정보의 양에도 범위가 있습니다. 이를 context size라는 말로 표현하기도 합니다. 저는 이것을 책상에 비유합니다. 책상 위에 한 가지 일에 필요한 자료만 올려두면 무엇을 해야 하는지 쉽게 찾을 수 있습니다. 반대로 여러 일의 메모와 자료를 모두 쌓아두면, 꼭 필요한 자료가 어디 있는지 찾기 어려워집니다. AI와의 대화도 같습니다. 대화가 길어질수록 처음에 정한 목표와 중요한 조건이 수많은 질문과 중간 결과 사이에 묻혀 방향을 잃을 수 있습니다. 그래서 저는 일이 크게 달라지거나 대화가 너무 길어지면 새 대화를 시작합니다. 대신 지난 대화 전체를 복사하지 않고, 다음 작업에 꼭 필요한 내용만 문서로 넘깁니다. AI도 지금 필요한 자료를 찾기 쉬워야 합니다. AI가 문서를 읽을 때는 정리 방식이 조금 달라집니다책상 위에 지금 필요한 자료만 남겨두는 것처럼, 새 대화를 시작할 때도 AI가 다음 작업에 사용할 내용을 골라서 보여줘야 합니다. 사람이 읽는 인수인계 문서를 그대로 활용할 수도 있지만, AI가 바로 이해하고 작업하려면 내용을 조금 다르게 정리하는 편이 좋습니다. 사람이 읽는 인수인계 문서는 길지 않고 전체 흐름을 쉽게 파악할 수 있어야 합니다. 중요한 배경과 결정, 다음 할 일을 중심으로 구성하면 좋습니다. 문서에 없는 내용은 동료에게 물어볼 수도 있습니다. 그러나 AI가 읽을 내용은 조금 다르게 정리합니다. 보기 좋은 보고서처럼 문장을 매끄럽게 다듬는 것보다, 다음 작업에 필요한 사실을 빠짐없이 적는 일이 더 중요합니다. 목표, 결정한 내용, 그렇게 결정한 이유, 하지 않을 일, 참고할 자료, 남은 일과 확인 방법을 글머리표로 나누어 적을 수 있습니다. AI는 문서에 없는 기업 사정이나 개별적인 경험을 주변 사람에게 물어볼 수 없습니다. 그래서 사람에게는 당연해 보이는 내용도 AI가 읽는 부분에는 직접 적어주는 편이 안전합니다. 같은 문서라도 사람은 빠르게 읽을 수 있어야 하고, AI가 읽을 때는 다음 작업에 필요한 정보가 명료해야 합니다. 누구나 간단하게 시작할 수 있습니다처음부터 여러 문서를 만들 필요는 없습니다. 아래 내용을 메모장이나 문서 도구에 적는 것만으로도 시작할 수 있습니다. 꼭 이 양식을 그대로 따르거나 별도의 문서를 만들 필요는 없습니다. 새 대화를 시작하는 프롬프트에 위 내용이 들어 있다면 같은 방식으로 활용할 수 있습니다. 새 대화를 시작할 때 이 문서나 프롬프트를 먼저 보여주고, AI에게 현재 상태를 짧게 정리해 달라고 요청해 보세요. 잘못 이해한 부분이 있다면 작업을 시작하기 전에 고칠 수 있습니다. 작업이 끝난 뒤에는 완료한 일과 다음 할 일을 다시 적습니다. 중요한 것은 모든 대화를 남기는 일이 아닙니다. 다음 작업에 필요한 결정과 이유가 빠지지 않았는지 확인하는 일입니다. 대화가 끝나도 업무의 흐름은 남아야 합니다AI용 인수인계 문서는 긴 대화를 줄여 놓은 요약문만은 아닙니다. 담당자가 바뀌거나, 새 채팅 세션을 열거나, 다른 AI 에이전트를 사용하더라도 현재 위치와 결정한 이유를 찾을 수 있게 해주는 공통 기록입니다. 좋은 문서가 있다고 모든 사람과 AI가 똑같은 답을 내는 것은 아닙니다. 하지만 이미 끝낸 논의를 되풀이하거나, 마친 일을 처음부터 다시 시작하는 일은 줄일 수 있습니다. 대화는 끝나도 업무의 흐름까지 끝날 필요는 없습니다. 누가 다음 작업을 맡든, 어떤 AI와 새 대화를 시작하든, 잘 정리된 인수인계 문서가 있다면 우리는 지난 대화를 되풀이하지 않고 다음 단계에서 다시 시작할 수 있습니다.
 정상운
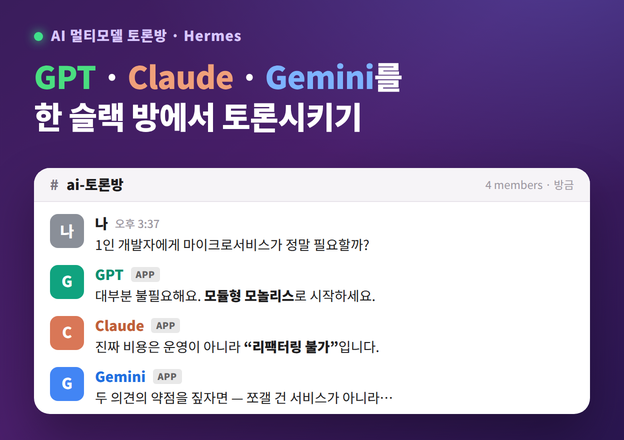
Hermes 멀티 모델 토론 봇 만들기
목표: Slack 한 스레드 안에서 나 + 세 개의 AI 봇(각각 다른 모델)이 함께 토론하기. @hermes → GPT-5.6 (기본, 이미 있음) @hermes-claude → Claude Opus 4.8 (새로 추가) @hermes-gemini → Gemini Flash (새로 추가) 커스텀 코드 없이 Hermes 프로필 기능만으로 만듭니다. 어떻게 작동하나요? Hermes의 프로필(profile) 은 "독립된 직원"이에요. 프로필마다 다른 모델, 다른 Slack 봇, 다른 기억을 가질 수 있어요. 프로필 = 서로 다른 참가자/직원 각 프로필은 자기만의 Slack 봇으로 워크스페이스에 등장 사용자가 스레드에서 @hermes-claude 어떻게 생각해? 하고 부르면 그 모델이 답하고, 각 봇은 스레드 내용을 읽어서 앞선 발언에 반박할 수 있어요 사용자가 사회자처럼 진행 핵심 규칙: 프로필마다 Slack 봇 토큰이 따로 있어야 해요. 그래서 봇마다 Slack 앱을 새로 만듭니다. 준비물이미 완성된 24/7 Hermes 서버 (DigitalOcean) : 설치 방법은 지난 블로그 글을 참고하세요 Claude와 Gemini에 접근할 방법 ← 아래 0단계에서 결정 Slack 앱 2개 새로 만들 시간 (봇당 약 5분) 0단계. 모델 접근 방법 정하기 (가장 중요)지금 서버는 OpenAI(gpt-5.6)만 연결돼 있어요. Claude와 Gemini를 부르려면 접근 수단이 필요해요. 두 가지 방법: 방법 A. OpenRouter 키 하나 (추천 ⭐)https://openrouter.ai 가입 → Keys 메뉴에서 키 1개 발급 (sk-or-...) 이 키 하나로 GPT·Claude·Gemini 전부 사용 가능 크레딧을 미리 충전(예: $10)해두면 사용한 만큼 차감 가장 간단해서 이 가이드는 A 기준으로 설명해요 방법 B. 각 사 키 따로Claude용: https://console.anthropic.com 에서 Anthropic API 키 Gemini용: https://aistudio.google.com 에서 Google AI 키 프로필마다 해당 키를 넣음 (더 번거롭지만 각 사 직접 과금) 아래 단계는 방법 A(OpenRouter) 기준입니다. 방법 B도 "제공자 선택" 부분만 다르고 나머지는 동일해요. 1단계. 프로필 2개 만들기서버 터미널(ssh root@서버IP)에서: hermes profile create hermes-claude hermes profile create hermes-gemini 확인: hermes profile list hermes-claude, hermes-gemini가 보이면 성공. 앞으로 특정 프로필에 명령하려면 hermes -p 프로필이름 ... 형태를 써요.예: hermes -p hermes-claude model 2단계. 각 프로필에 모델 연결하기hermes-claude 프로필 → Claude Opus 4.8hermes -p hermes-claude model 제공자 목록에서 OpenRouter 선택 OpenRouter 키(sk-or-...) 입력 모델 선택에서 Claude Opus 계열 선택 (예: anthropic/claude-opus-4.8) hermes-gemini 프로필 → Geminihermes -p hermes-gemini model 제공자 OpenRouter 선택 같은 OpenRouter 키 입력 모델 선택에서 Gemini 최신 계열 선택 (예: google/gemini-2.5-pro) 각 프로필에서 "Default model set to..." 가 뜨면 성공. 정확한 모델 ID는 시점에 따라 바뀔 수 있어요. hermes -p ... model 의 목록에서 골라 쓰면 항상 최신 걸 안전하게 선택할 수 있어요. 3단계. Slack 봇 2개 새로 만들기기본 봇을 만들 때 했던 그 절차를, 봇마다 한 번씩 반복해요. (이전 포스팅 Slack 연동 가이드의 5부 참고) 3-1. hermes-claude용 Slack 앱서버에서 매니페스트 생성: hermes -p hermes-claude slack manifest --agent-view --write 출력된 JSON 복사 cat .hermes/profiles/hermes-claude/slack-manifest.json * 참고: 출력된 slack-manifest.json 에서 Display Name 과 Bot Name 을 "Hermes" 에서 "Hermes-Claude"로 바꿔주세요. https://api.slack.com/apps → Create New App → From an app manifest 워크스페이스 선택 → JSON 붙여넣기 → Create 앱 이름을 hermes-claude 로 알아보기 쉽게 설정 (Basic Information에서 표시 이름 변경 가능) Socket Mode ON → 앱 레벨 토큰(xapp-) 발급·복사 Event Subscriptions ON → app_mention, message.channels 등 확인 Install App → Install to Workspace → 봇 토큰(xoxb-) 복사 3-2. hermes-gemini용 Slack 앱위 3-1을 똑같이 반복하되, -p hermes-gemini 로: hermes -p hermes-gemini slack manifest --agent-view --write 출력된 JSON 복사: cat .hermes/profiles/hermes-gemini/slack-manifest.json * 참고: 출력된 slack-manifest.json 에서 Display Name 과 Bot Name 을 "Hermes" 에서 "Hermes-Gemini"로 바꿔주세요.→ 새 Slack 앱 생성, 이름 hermes-gemini, 토큰 두 개(xapp-, xoxb-) 확보 결과적으로 봇마다 토큰 2개씩, 총 4개의 토큰이 생겨요. 어느 봇 건지 헷갈리지 않게 메모해두세요. 4단계. 각 프로필에 Slack 토큰 연결hermes -p hermes-claude gateway setupSlack 선택 → hermes-claude용 xoxb-, xapp- 입력 hermes -p hermes-gemini gateway setupSlack 선택 → hermes-gemini용 xoxb-, xapp- 입력 ⚠️ 중요 — "Choose how the gateway should run in the background" 화면이 뜨면 Skip service install for now를 선택하세요.새 프로필은 각자 서비스를 설치하면 안 돼요. 마지막 5단계에서 기본 프로필의 멀티플렉스 서비스 하나가 모든 프로필을 대신 돌립니다. 프로필마다 서비스를 따로 깔면 충돌이 나고 1GB 서버에 부담이 커져요.(User service / System service / Skip service install for now 중 → 방향키로 Skip 선택 → ENTER) 5단계. 한꺼번에 실행하기 (멀티플렉스)1GB 서버라 프로세스를 여러 개 띄우면 무거워요. 하나의 프로세스가 모든 프로필을 담당하게 설정해요. ⚠️ 중요 — 반드시 환경변수 방식으로 켜세요.hermes config set gateway.multiplex_profiles true 는 버전에 따라 "not a recognized config key" 경고가 뜨며 실제로 안 켜질 수 있어요. 가장 확실한 방법은 .env에 환경변수를 넣는 거예요 (우선순위: 환경변수 > config.yaml > 꺼짐): echo 'GATEWAY_MULTIPLEX_PROFILES=true' >> ~/.hermes/.env sudo hermes gateway restart --system 확인 — 로그에서 여러 봇이 각각 연결되는지 봅니다: tail -n 40 ~/.hermes/logs/gateway.log 아래처럼 프로필마다 Authenticated as @... 가 뜨고 Gateway running with N platform(s) 가 나오면 성공: ✓ slack connected (default, @hermes) ✓ slack connected (profile: hermes-claude, @hermes_claude) ✓ slack connected (profile: hermes-gemini, @hermesgemini) Gateway running with 3 platform(s) 새 프로필들은 별도 서비스로 install 하지 마세요(4단계에서 "Skip" 선택). 멀티플렉스가 켜지면 기본 서비스 하나가 모든 프로필을 알아서 챙깁니다.멀티플렉스는 호스트의 모든 프로필을 자동 포함해요. 안 쓰는 프로필이 있으면 같이 켜지니, 특정 프로필만 돌리려면 config.yaml의 gateway.multiplex_profile_allowlist로 제한할 수 있어요. 6단계. Slack에서 토론시키기Slack에서 토론할 채널을 하나 정하고, 세 봇을 모두 초대: /invite @hermes /invite @hermes-claude /invite @hermes-gemini 이제 토론 시작! 예시 흐름: 나: @hermes 이 주제로 토론을 시작하자. 주제: "1인 개발자에게 마이크로서비스가 과연 필요한가?" 네 입장은? @hermes (GPT): (입장 A 제시) 나: @hermes-claude GPT 의견 봤지? 너는 어떻게 생각해? @hermes-claude (Opus): (반박 또는 보완) 나: @hermes-gemini 두 의견의 약점을 짚어줘 @hermes-gemini (Gemini): (제3의 관점) 나: @hermes 셋의 의견을 종합해서 결론 내줘 각 봇은 스레드/채널 내용을 읽으니 서로의 발언에 반응해요. 사용자가 사회자처럼 순서를 정하며 진행하면 됩니다. 팁: 각 프로필의 성격을 SOUL.md로 다르게 줄 수 있어요. 예를 들어 hermes-claude는 "신중한 비판자", hermes-gemini는 "창의적 발상가"처럼. 서버에서 ~/.hermes/profiles/hermes-claude/SOUL.md 를 편집하면 돼요. ⭐ 꼭 해두기 — 부른 봇만 답하게 잠그기 (SLACK_STRICT_MENTION)기본 설정에선, 한 번 스레드에 참여한 봇은 그 스레드에서 멘션 없이도 계속 끼어들어요(auto-follow). 그러면 Claude를 불렀는데 기본 봇이 "이건 Claude한테 묻는 거니 난 빠질게" 같은 불필요한 답을 하거나, 여러 봇이 동시에 튀어나와요. 각 프로필의 .env에 아래를 넣으면 정확히 @멘션된 봇만 답해요 (토론 진행이 깔끔해짐): echo 'SLACK_STRICT_MENTION=true' >> ~/.hermes/.env echo 'SLACK_STRICT_MENTION=true' >> ~/.hermes/profiles/hermes-claude/.env echo 'SLACK_STRICT_MENTION=true' >> ~/.hermes/profiles/hermes-gemini/.env sudo hermes gateway restart --system 팁 — 봇 이름을 확실히 다르게봇 이름이 다 "Hermes~"로 시작하면 Slack 멘션 자동완성이 헷갈려요. 각 Slack 앱의 Basic Information / App Home에서 표시 이름을 GPT / Claude / Gemini 처럼 구분되게 바꾸면, @Claude 어때? 로 원하는 봇만 정확히 부를 수 있어요. 문제 해결특정 봇이 대답을 안 해요hermes -p hermes-claude gateway status tail -n 30 ~/.hermes/logs/gateway.log Provider auth failed → 그 프로필의 모델 연결이 안 된 것. hermes -p 프로필 model 다시 실행(유효한 키 + 모델 선택) → sudo hermes gateway restart --system Slack 관련 오류 → 토큰 재확인 한 봇을 불렀는데 다른 봇도 끼어들어요 / "저는 답변 보류할게요" 가 떠요→ 스레드 안에서 auto-follow가 작동한 거예요. 각 프로필 .env에 SLACK_STRICT_MENTION=true를 넣으세요(위 "부른 봇만 답하게 잠그기" 참고). 그러면 @멘션된 봇만 답합니다. "same bot token" 충돌 에러→ 두 프로필이 같은 Slack 토큰을 쓴 거예요. 봇마다 다른 Slack 앱/토큰이어야 해요. 3단계를 봇별로 따로 했는지 확인. 로그에 invalid_auth / slack failed to connect (profile: ...)→ 그 프로필의 Slack 봇 토큰이 틀렸다는 뜻이에요. 흔한 원인: 토큰을 잘못/일부만 붙여넣음 (또는 xoxb-와 xapp-를 바꿔 넣음) Slack 앱을 워크스페이스에 Install 안 함 → 봇 토큰이 활성화 안 됨 다른 앱의 토큰을 넣음 해결: 해당 앱에서 Install to Workspace 확인 → xoxb- 다시 복사 → hermes -p 프로필 gateway setup 으로 재입력 → sudo hermes gateway restart --system. 로그에 Authenticated as @... 가 뜨면 OK. 봇이 서로의 말을 못 알아듣는 것 같아요→ 각 봇 Slack 앱의 Event Subscriptions에 message.channels가 있고, 봇이 그 채널에 초대돼 있는지 확인. 그래야 스레드 내용을 읽어요. 서버가 느려지거나 멈춰요 (메모리 부족)→ 1GB 서버에서 세 모델이 동시에 무거운 답을 하면 빠듯할 수 있어요. 멀티플렉스(5단계)를 켰는지 확인하고, 그래도 부족하면 서버를 월 $12(2GB)로 올리는 걸 고려하세요. (DigitalOcean에서 Resize) 한 장 요약OpenRouter 키 발급 (GPT·Claude·Gemini 한 키로 접근) hermes profile create hermes-claude / hermes-gemini 각 프로필에 hermes -p ... model 로 Claude / Gemini 연결 Slack 앱 2개 새로 생성 → 봇 토큰(xoxb-,xapp-)씩 확보 hermes -p ... gateway setup 으로 각 프로필에 Slack 연결 .env에 GATEWAY_MULTIPLEX_PROFILES=true 추가 + 재시작 → 세 봇 동시 가동 Slack 채널에 세 봇 초대 → 사회자처럼 토론 진행 완성! 이제 GPT·Claude·Gemini와 함께 토론하는 Slack 방이 생겼어요. 🎭
 송경연
AI시대에 살아남는 엔지니어 1편: AI한테 "이 레거시 코드 파악해줘" 시켜봤다 — LLM이 잘하는 것과 절대 못 하는 것
"최신 ChatGPT나 Claude, Cursor에 수천 줄짜리 레거시 파일 하나 던져주고 '이 코드 파악해서 요약해줘' 하면 다 해결되는 것 아닌가요?" AI 도구가 급격히 발전하면서 많은 개발자와 경영진이 "이제 레거시 코드 분석도 AI가 알아서 다 해주는 시대가 왔다"고 오해합니다. 하지만 문서도 없고, 주석도 없고, 10년 넘게 비즈니스 로직이 기형적으로 꼬인 스파게티 레거시 코드를 LLM(대형 언어 모델)에 실제로 던져보면 기대와는 전혀 다른 아찔한 결과를 마주하게 됩니다. AI 도구를 활용해 레거시 시스템을 파악할 때 LLM이 압도적으로 잘하는 영역과 AI를 맹신했다간 시스템을 터뜨리게 되는 '절대 못 하는 영역'의 경계를 명확히 정리합니다. 1. LLM이 압도적으로 '잘하는' 영역 (AI를 200% 활용하는 법)AI는 문맥이 단절된 파편화된 코드를 분석하거나 난독화된 구문을 해독하는 데 엄청난 생산성을 발휘합니다. 난독화/스파게티 구문 해석 및 리팩토링 제안: 변수명이 $a, $tmp2처럼 엉망이거나, 깊은 삼중 if문으로 꼬여있는 100줄짜리 함수를 던져주면 "이 함수는 유저의 결제 상태값을 검증하는 구문입니다"라며 깔끔한 가독성 높은 코드로 재작성해 줍니다. 구형 프레임워크/언어 문법 현대화 번역: PHP 5.x의 구형 DB 함수나 obsolete된 라이브러리 구문을 최신 PHP 8.x/Node.js 문법으로 변환할 때, 단순 문법적 치환(Syntax Migration)은 AI가 인간보다 10배 이상 빠릅니다. 단위 테스트(Unit Test) 보일러플레이트 생성: 분석한 함수의 입력값과 출력값을 기반으로 Edge Case(예외 상황)를 고려한 테스트 코드를 빠르게 작성해 줍니다. 2. LLM이 '절대 못 하는' 영역 (AI의 치명적 한계 3가지)반면, 레거시 시스템의 핵심인 '숨겨진 맥락'과 '비즈니스의 숨겨진 룰' 앞에서 AI는 무력해집니다. ① '숨은 비즈니스 로직(Implicit Rules)' 파악 불가 // 레거시 코드 속 이상한 예외 처리 if ($user_id == 8492 && $total_price > 100000) { $discount_rate = 0.15; }AI에게 이 코드를 물어보면 "특정 유저 ID와 금액 조건에 따른 할인 로직입니다"라고 답합니다.하지만 이 코드가 "5년 전 VIP 고객이었던 특정 기업과의 구두 계약 때문에 임시로 넣어둔 예외 로직"이라는 비즈니스 배경(Domain Knowledge)은 AI가 절대 알 수 없습니다. AI 말만 믿고 이 코드를 "불필요한 하드코딩"이라며 지웠다간 대형 비즈니스 클레임이 터집니다. ② 시스템 전체의 '숨겨진 사이드 이펙트(Side Effect)' 예측 불가 레거시 시스템은 DB Trigger, 외부 API, 크론잡(Cronjob), 공통 세션 등이 얽혀있는 경우가 많습니다. AI는 자신이 텍스트로 입력받은 파일 범위 내에서만 사고하므로, "이 파일의 A 함수를 고쳤을 때 새벽 3시에 도는 정산 크론잡이 터진다"는 거시적인 파급 효과를 예측하지 못합니다. ③ '존재하지 않는 로직'을 진실처럼 말하는 환각(Hallucination) 레거시 코드가 너무 복잡하거나 세션/글로벌 변수에 의존할 때, LLM은 자기가 모른다는 사실을 인정하는 대신 그럴듯한 가짜 동작 원리를 만들어내면서 설명(Hallucination)합니다. AI의 거짓말을 믿고 리팩토링을 진행했다가 런타임 에러를 맞닥뜨리는 경우가 수두룩합니다. 3. 실무자를 위한 'AI 기반 레거시 파악' 올바른 워크플로우AI는 '코드 단위의 번역기/요약기'로만 사용한다: 전체 아키텍처나 비즈니스 판단을 맡기지 말고, 특정 메서드나 쿼리의 의도를 파악하는 보조 도구로만 제한합니다. "왜 이 코드가 작성되었는가?"는 사람(기획자, DB 기록, Git History)이 찾는다: 코드의 '형태'는 AI가 보고, 코드 뒤에 숨은 '이유'는 엔지니어가 검증해야 합니다. AI가 작성해 준 분석을 토대로 '검증용 테스트'를 먼저 돌린다: AI의 요약 답변을 100% 믿지 말고, 반드시 실제 입력/출력값 테스트를 거쳐 검증합니다. 마무리하며AI는 레거시 현대화의 훌륭한 '보조 항해사(Copilot)'는 될 수 있지만, 배의 키를 잡는 '선장(Captain)'이 될 수는 없습니다. 결국 AI가 읽어내지 못하는 비즈니스의 역사, 의사결정의 배경, 시스템의 전체 맥락을 짚어내는 것은 숙련된 베테랑 엔지니어의 경험과 직관입니다. AI 도구를 현명하게 도구로 활용할 때, 레거시 분석 속도는 비로소 안전하게 5배 이상 빨라질 수 있습니다.
 gwihyeon jo
만원으로 24시간 돌아가는 Hermes 설치하기
이 문서 하나면 개발을 몰라도 따라 할 수 있어요.목표: 노트북을 꺼도 Slack에서 @Hermes를 부르면 24시간 언제나 답하는 AI 봇 만들기. 먼저, 우리가 뭘 만드는 건지 (1분 개념)Hermes: AI 에이전트. 내 노트북에서 설치하면 노트북을 끄면 멈춰요. VPS(=클라우드 서버): 데이터센터에 있는, 항상 켜져 있는 나만의 컴퓨터. 월 몇 천 원에 빌려요. 아이디어: Hermes를 이 항상 켜진 서버에 올려두면, 내 노트북 상태와 상관없이 24시간 동작하고 Slack을 통해 대화할 수 있어요 우리는 DigitalOcean이라는 서비스에서 서버를 빌립니다. (초보자에게 가장 쉬운 편) 미리 알아둘 비용서버 (DigitalOcean): 월 $6 / 항상 켜진 컴퓨터 값 (고정) AI 모델 사용료: 사용한 만큼 / 봇의 두뇌, OpenAI 등에 질문할 때마다 조금씩 과금 서버 $6는 "집세", 모델 사용료는 "전기세"라고 생각하면 쉬워요. 준비물신용카드 (DigitalOcean 가입용) 맥 또는 윈도우 컴퓨터 (설정하는 동안만 필요) Slack 워크스페이스 (관리자 권한) AI 모델 계정 하나 (예: OpenAI) — 봇의 두뇌용 1부. 서버 만들기 (DigitalOcean)1-1. 가입https://www.digitalocean.com 에서 가입 → 카드 등록.(가입 시 "$5 Inference 크레딧" 안내가 떠도 무시하세요. 우리가 쓸 서버와는 다른 상품이에요.) 1-2. 서버(Droplet) 생성로그인 후 우측 상단 Create → Droplets 클릭 Region(지역): Singapore (한국에서 가장 빠름) OS: Ubuntu → 최신 LTS 버전 (예: 24.04) Droplet Type: Basic → Regular 크기: 월 $6 짜리 (1GB RAM / 1 CPU) 선택 — 봇 하나엔 충분 Authentication(로그인 방식): SSH Key 선택 (아래 1-3 참고) Hostname: hermes-bot 처럼 알아보기 쉬운 이름 맨 아래 Create Droplet 클릭 → 1분 뒤 서버 IP 주소(예: 203.0.113.10)가 생겨요. 복사해두세요. 1-3. SSH 키 만들기 (서버 열쇠, 1번만)서버에 안전하게 접속하기 위한 "디지털 열쇠"예요. 맥 터미널(응용프로그램 → 유틸리티 → 터미널)에서: ssh-keygen -t ed25519 -C "hermes"질문이 3번 나오면 그냥 엔터 3번 (기본값 사용), 아래 명령어로 출력 (cat: 파일 출력) cat ~/.ssh/id_ed25519.pub출력된 긴 문자열 전체를 복사 → DigitalOcean의 New SSH Key 칸에 붙여넣기 SSH Key name: 아무거나 (예: 내-맥북) — 그냥 이름표예요 2부. 서버에 접속하기맥 터미널에서 (서버IP는 1-2에서 복사한 주소): ssh root@서버IP 처음 접속 시 yes 입력 프롬프트가 root@hermes-bot:~# 처럼 바뀌면 서버 안에 들어온 것이에요. 이제부터 명령어는 이 서버에서 실행돼요. 💡 중요: 앞으로 "서버에서"라고 하면 이 화면(root@... 로 시작), "내 컴퓨터에서"라고 하면 접속 전 일반 터미널이에요. 헷갈리면 화면 맨 앞 글자를 보세요. 3부. Hermes 설치하기서버 안에서 순서대로: apt update && apt -y upgrade curl -fsSL https://hermes-agent.nousresearch.com/install.sh | bash source ~/.bashrc 설치 중 몇 가지 선택지가 나와요: Select terminal backend → Local 선택 (지금 이 서버에서 실행한다는 뜻) 나머지는 일단 넘어가도 돼요. 뒤에서 다시 설정합니다. 설치 확인: hermes --version 버전 숫자가 나오면 성공. 4부. 봇의 "두뇌"(AI 모델) 연결하기봇은 스스로 생각하지 않고, 외부 AI 모델(GPT 등)에 물어봐서 답해요. 이걸 연결 안 하면 봇이 "Provider authentication failed" 에러를 냅니다. 서버에서: hermes model제공자 목록이 나오면 하나 선택 (예: OpenAI) 안내에 따라 로그인/API 키 입력 OpenAI의 경우: 화면에 뜬 URL을 브라우저로 열고 → 코드 입력 → 로그인 "Default model set to..." 가 뜨면 성공 💡 내 노트북에서 쓰던 모델 로그인은 서버로 자동으로 넘어오지 않아요. 서버에서 한 번 더 로그인해야 합니다. 5부. Slack 연동하기5-1. Slack 앱 만들기① 앱 설계도(매니페스트) 생성 — 서버에서: hermes slack manifest --agent-view --write→ 화면에 나온 JSON 내용을 전부 복사해두세요. (출력 명령어: cat 파일경로) ② Slack 앱 생성 브라우저에서 https://api.slack.com/apps 접속 (Slack이 처음이라면) 회원 가입 후 워크스페이스 생성 Create New App → From an app manifest 선택 워크스페이스 선택 → 위에서 복사한 JSON 붙여넣기 → Create 5-2. 권한 & 기능 켜기만든 앱 설정 화면에서 (매니페스트로 만들면 대부분 자동 설정돼 있지만, 확인): ③ OAuth 권한 — 왼쪽 메뉴 OAuth & Permissions → Bot Token Scopes에 아래가 있는지 확인:chat:write, app_mentions:read, channels:history, im:history, im:read, im:write, users:read ④ Socket Mode 켜기 — 왼쪽 메뉴 Socket Mode → 토글 ON 앱 레벨 토큰 만들라고 하면: 이름 아무거나, 권한 connections:write → 생성 나오는 xapp-로 시작하는 토큰을 복사해두세요 ← (앱 토큰) ⑤ 이벤트 구독 — 왼쪽 메뉴 Event Subscriptions → 토글 ON → Subscribe to bot events에 아래 추가:app_mention, message.im, message.channels(단체 DM도 쓰려면 message.mpim도 추가) ⑥ 챗 탭 켜기 — 왼쪽 메뉴 App Home → Chat Tab 켜고, "Allow users to send..." 체크 5-3. 앱 설치 & 토큰 받기⑦ 워크스페이스에 설치 — 왼쪽 메뉴 Install App → Install to Workspace → 허용 나오는 xoxb-로 시작하는 토큰을 복사 ← (봇 토큰) 이제 토큰 두 개가 손에 있어야 해요: 봇 토큰: xoxb-... 앱 토큰: xapp-... 5-4. Hermes에 토큰 입력서버에서: hermes gateway setup플랫폼 목록에서 Slack 선택 봇 토큰(xoxb-), 앱 토큰(xapp-) 순서대로 붙여넣기 5-5. 봇을 채널에 초대Slack에서 봇을 쓰고 싶은 채널에 들어가 메시지 입력창에: /invite @Hermes6부. 24시간 자동 실행 등록 ⭐ 핵심서버에서 (이 명령이 "노트북 꺼도 계속 돌게" 만드는 부분): sudo hermes gateway install --system --run-as-user root "Start now?" → Y "Start on boot?" → Y 상태 확인: hermes gateway status --system ✓ System gateway service is running 이 보이면 성공! 🎉 서버가 재부팅돼도 자동으로 다시 켜집니다. 7부. 테스트Slack에서 @Hermes 를 멘션하고 아무거나 물어보세요 (예: "안녕").봇이 답하면 완성이에요. 이제 노트북을 꺼도 24시간 작동합니다. 보너스. Telegram도 추가하기 (쉬움 ⭐)Hermes는 Slack 말고도 Telegram, Discord, WhatsApp, Signal, iMessage, LINE 등 20개 넘는 메신저를 지원해요. 하나의 봇이 여러 메신저에 동시에 붙을 수 있어요. 그중 Telegram이 제일 쉬워요. Slack처럼 앱 만들고 권한 설정하는 복잡한 과정 없이, 봇 하나 만들고 토큰 하나만 받으면 5분이면 끝나요. B-1. 텔레그램에서 봇 만들기 (BotFather)텔레그램 앱에서 @BotFather 검색 → 대화 시작 /newbot 입력 봇 이름 입력 (아무거나, 예: Trinity's Hermes) 봇 사용자명 입력 → 반드시 bot으로 끝나야 함 (예: trinity_hermes_bot) BotFather가 주는 토큰 복사 (비밀번호처럼 중요): 8123456789:AAH1a2B3c4D5e6F7g8H9... B-2. 내 텔레그램 ID 알아두기 (나만 쓰게 잠그기, 권장)텔레그램 봇은 기본적으로 누구나 말 걸 수 있어요. 나만 쓰려면 내 숫자 ID가 필요해요. 텔레그램에서 @userinfobot 검색 → 대화 시작 → 아무 메시지나 전송 Id: 123456789 같은 숫자를 알려줘요. 복사. B-3. 서버에 연동서버에서: hermes gateway setup플랫폼 목록에서 Telegram 선택 봇 토큰(B-1) 붙여넣기 허용 사용자(allowed users)를 물으면 → 내 숫자 ID(B-2) 입력 재시작: sudo hermes gateway restart --system B-4. 테스트텔레그램에서 내가 만든 봇(예: @trinity_hermes_bot)을 검색 → 대화 시작 → "안녕" 전송. 답하면 완성! 💡 다른 메신저(Discord 등)도 방식은 똑같아요: 해당 앱에서 봇 토큰을 받아 hermes gateway setup에서 고르고 넣으면 돼요. Slack·Telegram 봇이 동시에 같은 서버에서 돌아갑니다. 자주 쓰는 명령어 모음 (서버에서)맥이나 윈도우 터미널에서 아래 명령으로 서버에 접속 후 실행 ssh [email protected] -> Digital Ocean 'droplet' 에 추가한 서버의 IP 주소로 대체 봇 상태 보기 : hermes gateway status --system 봇 재시작: sudo hermes gateway restart --system 봇 멈추기: sudo hermes gateway stop --system 로그 보기: tail -n 30 ~/.hermes/logs/gateway.log 전체 점검: hermes doctor 모델 바꾸기: hermes model 한 장 요약DigitalOcean에서 $6 서버(Droplet) 만들기 (Ubuntu, 싱가포르) ssh root@서버IP 로 접속 install.sh 로 Hermes 설치 (backend = Local) hermes model 로 AI 모델 연결 ← 빼먹지 말기 Slack 앱 만들고 토큰(xoxb-, xapp-) 받아 hermes gateway setup sudo hermes gateway install --system --run-as-user root 로 24/7 등록 Slack에서 @Hermes 테스트 끝! 이제 노트북 없이도 24시간 도는 나만의 AI 봇이 생겼어요. 🎉
송경연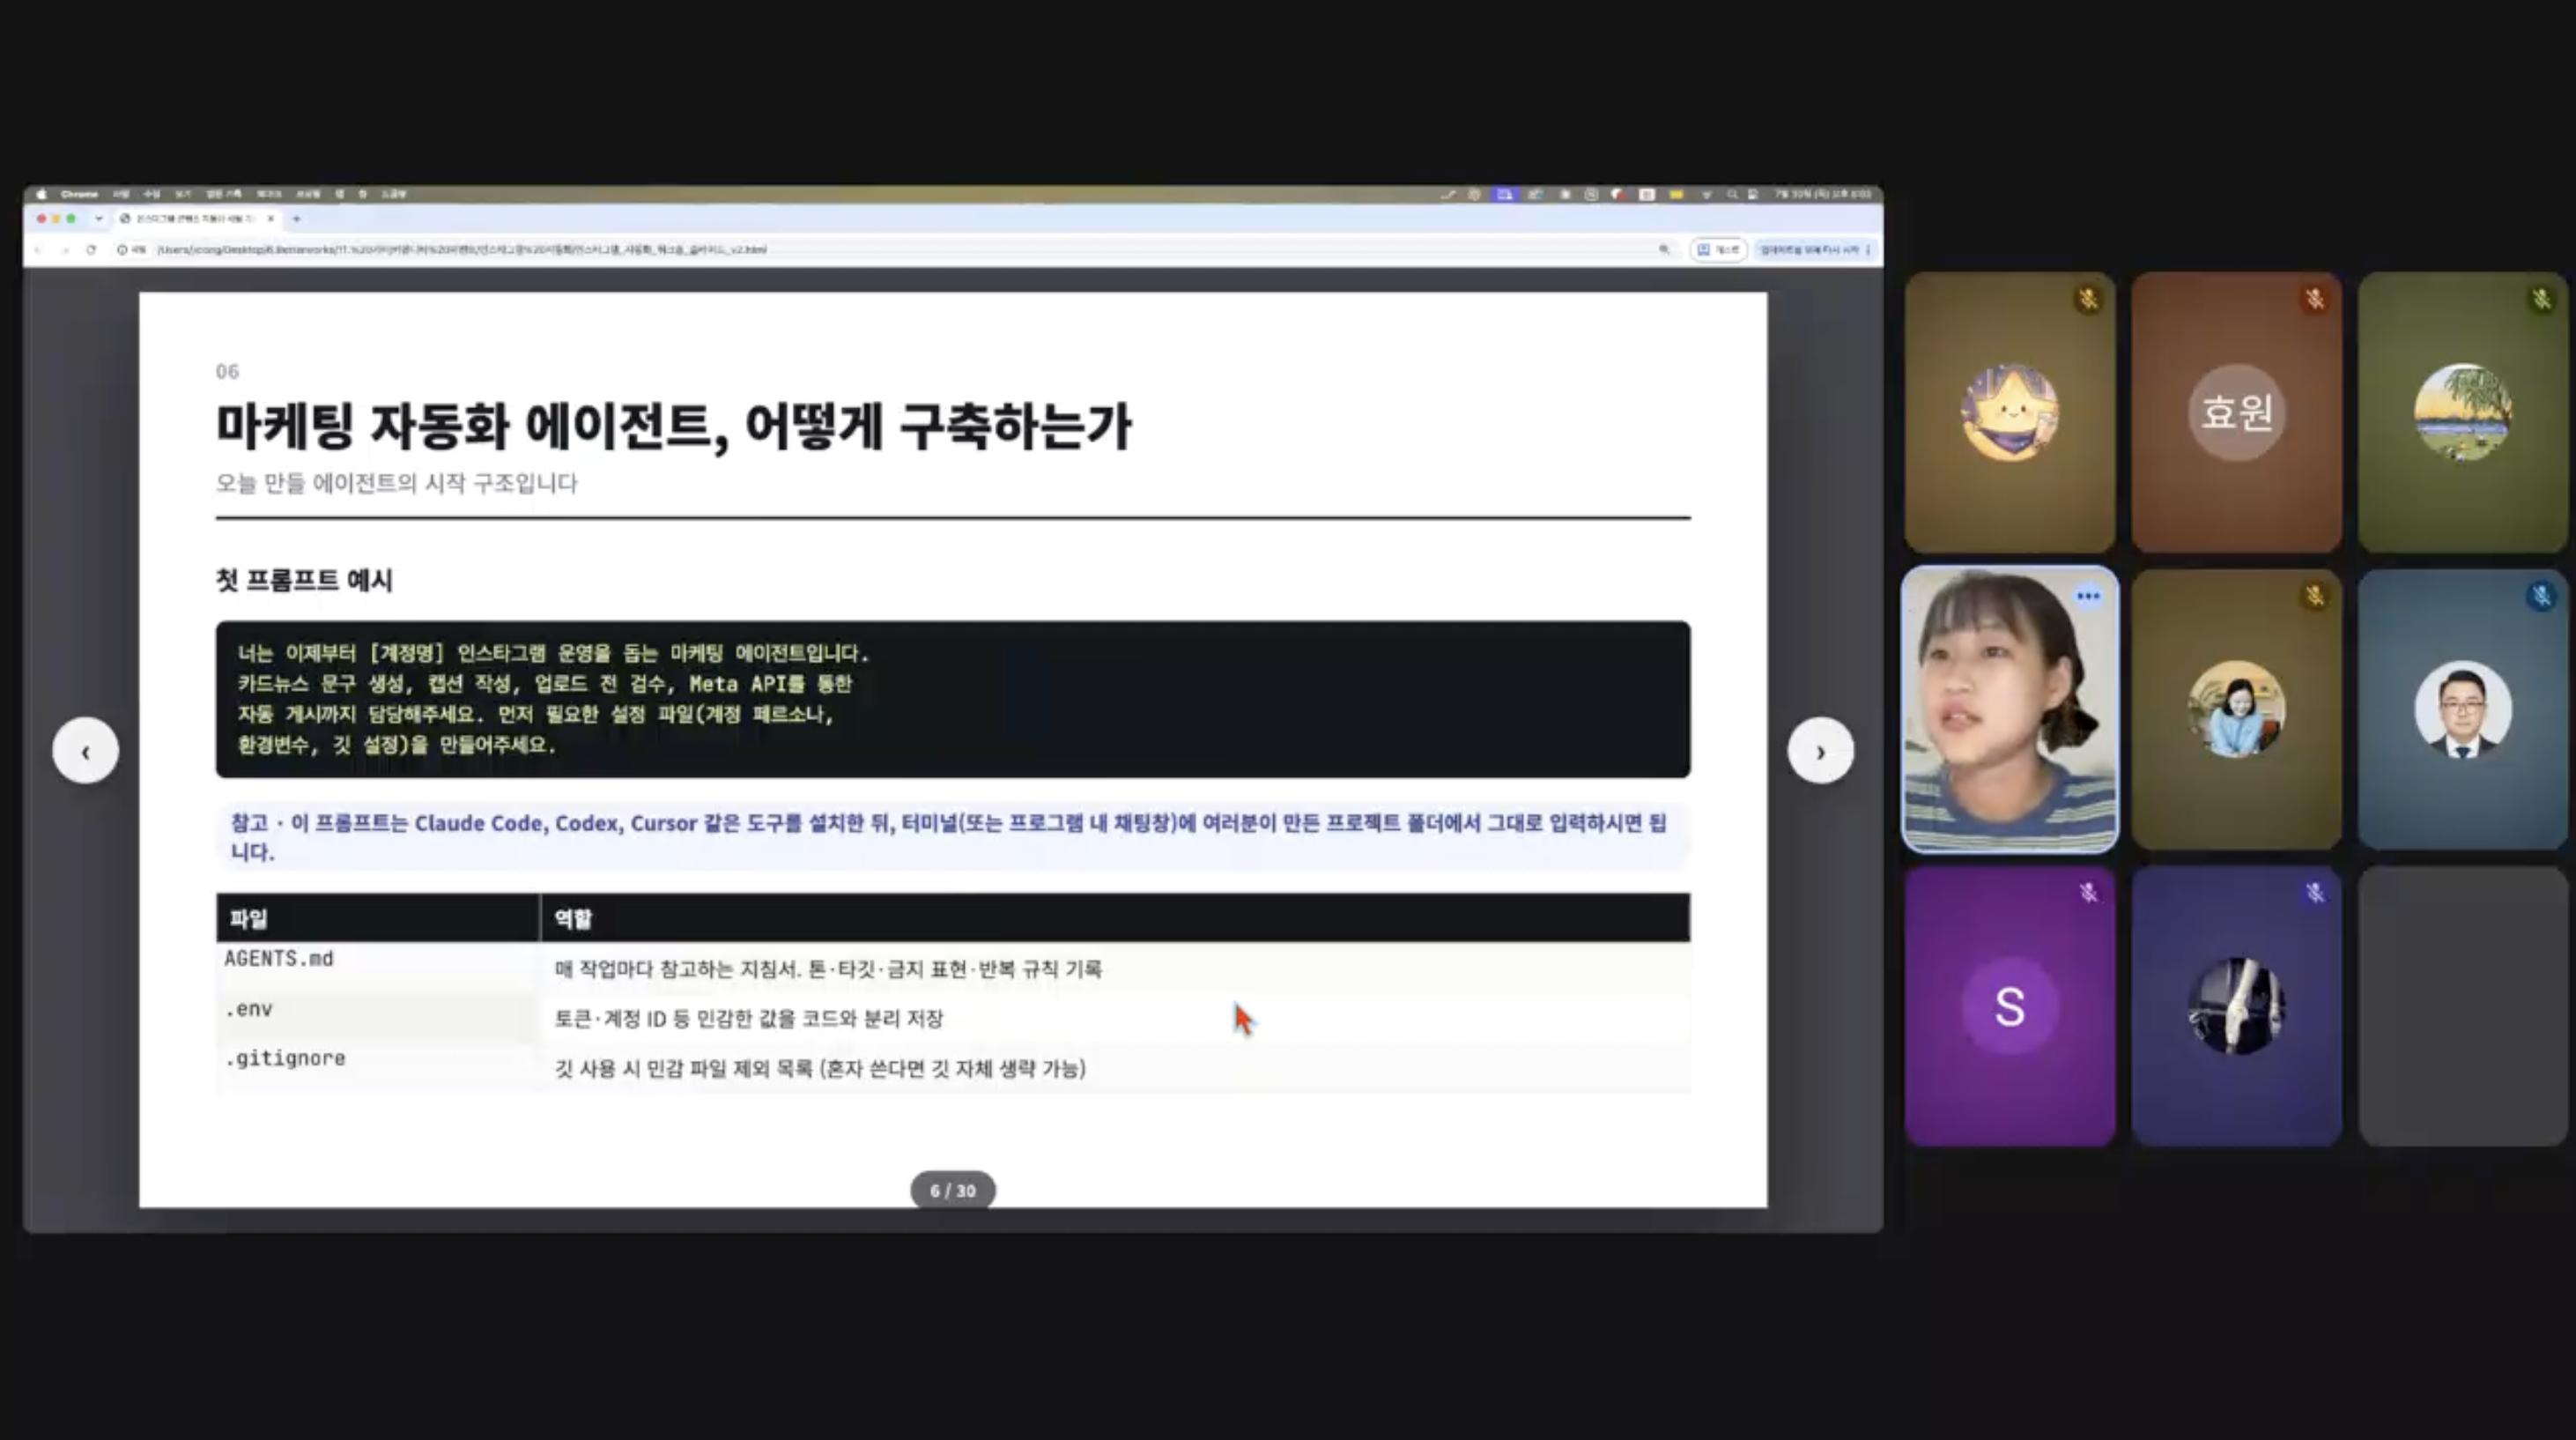
인스타그램 콘텐츠 자동화: 제작부터 Meta API 자동 게시까지
인사이트 요약 👀인스타그램 콘텐츠 제작부터 게시까지, 반복되는 과정을 어떻게 하나의 자동화 흐름으로 연결할 수 있을까요? 지난 7월 30일 플렉스웍 AI 챌린지 클럽에서 진행한 ‘미뤄뒀던 인스타그램 콘텐츠 자동화, 함께 세팅해요!’ 워크숍에서는 주제를 입력하면 카드뉴스 문구와 캡션을 만들고, 이미지를 제작한 뒤 Meta API를 통해 실제 게시까지 이어지는 과정을 함께 살펴봤습니다. 단순히 콘텐츠를 생성하는 데서 끝나는 것이 아니라, AI 에이전트가 작업 기준과 템플릿을 참고해 결과물을 만들고, 필요한 검수를 거쳐 인스타그램에 게시하는 전체 프로세스를 직접 연결해보는 것이 이번 워크숍의 주요 내용이었습니다. 콘텐츠 제작 과정을 자동화 가능한 단위로 나누는 방법 AGENTS.md와 HTML 템플릿으로 결과물의 편차를 줄이는 방법 Meta API 연결 과정에서 자주 막히는 권한과 토큰 설정 자동 게시 전 반드시 남겨야 할 콘텐츠 검수 단계 인스타그램 콘텐츠 하나를 올리려면 생각보다 많은 작업이 필요합니다.주제를 정하고, 카드뉴스 문구를 작성하고, 이미지를 만든 뒤 캡션을 다듬습니다. 완성된 콘텐츠를 다시 확인하고 인스타그램에 접속해 게시하는 일도 남아 있습니다. 한두 번은 직접 할 수 있지만, 꾸준히 운영하려면 이 과정이 계속 반복됩니다. 일정이 바빠질수록 콘텐츠 발행이 가장 먼저 밀리는 이유이기도 합니다. 이번 워크숍은 완성된 자동화 도구를 소개하는 강의보다, 실제로 자동화 환경을 만들면서 어디에서 막히는지 함께 확인하는 실습에 가까웠습니다. Claude Code, Codex, Cursor와 같은 AI 도구를 활용해 콘텐츠를 만들고, Meta API를 통해 게시하는 흐름을 살펴봤습니다. 그 과정에서 한 가지가 분명해졌습니다. 인스타그램 자동화의 시작점은 API가 아니라 콘텐츠가 만들어지는 과정을 정리하는 일이었습니다. ① 자동화는 ‘업로드 버튼’을 대신하는 일이 아닙니다콘텐츠 하나가 게시되기까지의 과정을 나누면 대략 다음과 같습니다. 주제 입력 → 문구와 캡션 작성 → 이미지 제작 → 내용 검수 → API 호출 → 게시 결과 확인 이 과정이 보여야 AI에게 어떤 일을 맡길지 정할 수 있습니다. 예를 들어 주제와 초안을 만드는 일은 AI에게 맡기더라도, 브랜드에 맞지 않는 표현을 확인하거나 민감한 내용을 검토하는 일은 사람이 맡을 수 있습니다. 게시 결과를 확인하고 오류에 대응하는 단계도 따로 필요합니다. 처음부터 모든 과정을 AI에게 넘기면 어디에서 문제가 발생했는지 찾기 어렵습니다. 반대로 작업을 단계별로 나눠두면 특정 단계만 수정하거나 다시 실행할 수 있습니다. 자동화에서 중요한 것은 사람을 완전히 빼는 것이 아니라, 사람이 반복해서 처리하던 일과 직접 판단해야 할 일을 구분하는 것입니다. ② 결과물이 매번 달라진다면, 기준부터 파일로 남겨야 합니다AI를 활용해 콘텐츠를 만들 때 자주 발생하는 문제는 결과의 편차입니다. 같은 계정에 올릴 콘텐츠인데도 문체가 달라지거나, 카드뉴스 구성이 매번 바뀔 수 있습니다. 피해야 할 표현이 다시 등장하고, 지난번에 수정했던 내용을 다음 작업에서 또 설명해야 하는 경우도 있습니다. 이를 줄이기 위해 계정의 기준을 AGENTS.md에 정리했습니다. 다음과 같은 내용을 파일에 남길 수 있습니다. 계정에서 주로 다루는 주제 콘텐츠를 읽을 주요 대상 문장과 말투의 기준 사용하지 않을 표현 카드뉴스의 기본 구성 캡션과 CTA의 작성 방식 게시 전 확인할 검수 항목 예를 들어 카드뉴스를 항상 ‘표지 1장, 본문 3장, CTA 1장’으로 만든다면 이 규칙도 파일에 기록합니다. 이렇게 기준을 남기면 콘텐츠를 만들 때마다 긴 프롬프트를 처음부터 작성하지 않아도 됩니다. AI가 기존 기준을 읽고 다음 작업에도 같은 방식을 적용할 수 있습니다. 핵심은 완벽한 프롬프트 하나를 만드는 것이 아닙니다. 콘텐츠를 만들고 수정하며 알게 된 기준을 다음 작업에서도 사용할 수 있도록 계속 쌓는 것이 중요합니다. ③ 디자인 품질은 ‘새로운 결과’보다 ‘반복 가능한 틀’에서 나왔습니다문구뿐만 아니라 디자인도 결과의 편차가 컸습니다. AI에게 매번 새로운 카드뉴스 디자인을 만들게 하면 어떤 결과물은 괜찮지만, 다음 결과물은 같은 계정에서 만든 콘텐츠처럼 보이지 않을 수 있습니다. 그래서 인터뷰, 인사이트, 이벤트 홍보 등 콘텐츠 용도에 따라 약 10개의 HTML 템플릿을 만들어 활용했습니다. AI가 매번 화면 전체를 새로 디자인하는 대신, 콘텐츠 유형에 맞는 템플릿을 선택하고 정해진 영역의 내용만 바꾸도록 한 것입니다. 이 방식에는 몇 가지 장점이 있었습니다. 카드뉴스의 기본 레이아웃을 일정하게 유지할 수 있습니다. 텍스트가 들어가는 위치와 분량을 미리 제한할 수 있습니다. 이미 검토한 디자인을 다음 콘텐츠에도 사용할 수 있습니다. 결과물에 문제가 생겼을 때 템플릿과 콘텐츠 중 어느 부분을 수정해야 하는지 구분하기 쉽습니다. Figma 디자인 레이어를 AI가 읽을 수 있도록 MCP로 연결하는 방법도 활용할 수 있습니다. 이 과정이 어렵다면 기존 디자인 이미지를 참고하게 한 뒤 HTML 템플릿으로 구현하는 방식도 가능합니다. 중요한 것은 AI가 매번 얼마나 새로운 디자인을 만들어내는지가 아닙니다. 이미 검토한 디자인을 얼마나 안정적으로 반복할 수 있는가가 자동화 운영에서는 더 중요했습니다. ④ Meta API 연결, 같은 오류처럼 보여도 원인은 달랐습니다콘텐츠 제작 흐름을 만들었다면 다음은 실제 게시 연결입니다. 이 과정에서는 Meta Developer 앱과 Instagram 프로페셔널 계정, 액세스 토큰, 게시 권한 등을 확인해야 합니다. 하지만 계정마다 설정 상태가 달라 같은 순서로 진행해도 결과가 같지 않았습니다. 워크숍에서는 일부 계정에서 Instagram 테스터 역할을 추가한 뒤, 초대받은 계정이 이를 직접 수락해야 연결되는 경우가 있었습니다. 액세스 토큰 발급이 원활하지 않을 때는 그래프 API 탐색기를 통해 다른 발급 경로를 확인하기도 했습니다. 연결이 되지 않을 때는 같은 작업을 반복하기보다 문제를 나눠 확인하는 편이 빨랐습니다. Meta API 연결이 막힐 때 확인할 것Instagram 계정이 프로페셔널 계정인지 Instagram 계정과 Facebook 페이지가 정상적으로 연결됐는지 Meta 앱에 필요한 계정이 추가됐는지 테스터 초대가 필요한 경우 계정에서 수락했는지 콘텐츠 게시에 필요한 권한이 포함됐는지 액세스 토큰이 올바른 계정으로 발급됐는지 토큰의 권한 범위와 유효기간에 문제가 없는지 오류 화면은 비슷해 보여도 계정 연결, 역할, 권한, 토큰 등 원인은 서로 다를 수 있습니다. 따라서 ‘게시가 되지 않는다’는 문제를 한 번에 해결하려 하기보다, 계정 연결부터 게시 권한까지 단계별로 확인하는 방식이 필요합니다. ⑤ 토큰은 발급보다 ‘어디에 보관하는가’가 중요합니다액세스 토큰과 앱 시크릿은 외부에 노출되면 안 되는 정보입니다. 액세스 토큰은 대상 Instagram 계정에 접근하고, 허용된 작업을 실행하는 데 사용됩니다. 앱 시크릿은 일부 로그인과 토큰 발급 과정, 서버 측 호출을 보호할 때 사용됩니다. 둘 다 비밀번호처럼 관리해야 합니다. 실제 값을 코드 파일이나 AI 대화창에 직접 작성하면 실수로 외부에 노출될 수 있습니다. 따라서 별도의 .env 파일에 값을 저장하고, 코드에서는 환경변수를 불러오는 방식으로 관리했습니다. Git을 사용한다면 .gitignore에 .env를 추가해 저장소에 올라가지 않도록 해야 합니다. 권한도 처음부터 모두 추가할 필요는 없습니다. 계정 정보 확인과 콘텐츠 게시처럼 지금 필요한 권한부터 설정하고, 댓글 관리나 인사이트 조회 기능을 붙일 때 관련 권한을 추가하는 편이 관리하기 쉽습니다. 자동화를 만들 때는 기능 구현뿐 아니라 접근 정보가 어디에 저장되고, 누가 사용할 수 있는지까지 함께 설계해야 합니다. ⑥ 게시에 성공해도 콘텐츠 검수는 끝나지 않습니다API 요청이 성공하고 콘텐츠가 정상적으로 게시되면 자동화가 완성된 것처럼 느껴질 수 있습니다. 하지만 게시에 성공했다는 것은 기술적으로 요청이 처리됐다는 의미일 뿐, 콘텐츠의 품질까지 보장하지는 않습니다. 게시 전에는 다음 내용을 다시 확인해야 합니다. 오탈자나 어색한 문장이 없는지 계정에서 사용하는 말투와 맞는지 사실과 다른 내용이 포함되지 않았는지 과장되거나 민감한 표현이 없는지 이미지와 캡션의 내용이 서로 일치하는지 CTA와 링크가 올바르게 연결됐는지 AI가 1차 검수를 맡을 수는 있지만, 운영 초기에는 사람이 결과물을 직접 확인하는 편이 안전합니다. 처음부터 생성과 검수, 게시까지 모두 자동으로 실행하기보다, 게시 직전에 사람이 승인하는 단계를 두는 방법도 있습니다. 자동화의 목적은 검수를 없애는 것이 아니라, 사람이 확인해야 할 콘텐츠를 더 빠르고 일정한 형태로 준비하는 것에 가깝습니다. 처음부터 전부 자동화하지 않아도 됩니다자동화를 시작할 때 가장 부담스러운 생각은 모든 과정을 한 번에 연결해야 한다는 것입니다. 하지만 실제로는 작은 단위부터 확인하는 편이 훨씬 현실적입니다. 먼저 AGENTS.md에 콘텐츠 기준을 정리합니다. 다음으로 자주 사용하는 콘텐츠 형식 하나를 HTML 템플릿으로 만듭니다. 이후 테스트 이미지 한 장을 이용해 게시 흐름을 확인합니다. 기본 흐름이 작동하면 그다음에 기능을 추가할 수 있습니다. 여러 장의 이미지를 올리는 캐러셀 게시 캡션 자동 생성 게시 전 문구 검수 콘텐츠 유형별 템플릿 선택 게시 결과와 오류 기록 일정에 맞춘 예약 실행 작은 테스트부터 시작하면 문제가 생겼을 때 원인을 찾기 쉽고, 실제로 필요한 기능이 무엇인지도 더 분명해집니다. 함께 실습하며 확인한 자동화의 핵심혼자 가이드를 따라갈 때는 오류가 발생하면 무엇부터 확인해야 할지 막막할 수 있습니다. 함께 실습해보니 계정마다 연결 상태와 권한이 달랐고, 서로 다른 지점에서 문제가 발생했습니다. 그 과정에서 나온 질문들은 계정 연결, 토큰 발급, 콘텐츠 품질을 확인하는 새로운 체크리스트가 됐습니다. 완성된 자동화 도구를 보여주는 것보다, 직접 만들며 막혔던 지점을 함께 나누는 일이 더 도움이 될 때가 있습니다. 자동화를 시작하고 싶다면 거대한 시스템부터 만들 필요는 없습니다. 지금 반복하고 있는 업무 하나를 선택하고, 그 일이 어떤 순서로 진행되는지 나눠보세요. 반복해서 사용할 기준을 만들고, 가장 작은 결과물부터 테스트해보는 것이 시작입니다. AI를 잘 사용하는 것만큼 중요한 것은 내가 일하는 방식을 AI가 반복할 수 있는 구조로 정리하는 능력입니다. 직접 실험한 AI 활용 방식이나 업무 노하우가 있다면 Flexwork에서 다른 사람들과 나눠보세요. 완성된 전문가가 아니어도 괜찮습니다. 직접 시도하면서 알게 된 과정과 시행착오가 누군가에게는 가장 현실적인 가이드가 될 수 있습니다. 👉 Flexwork 커뮤니티 리더로 시작하기
플렉스웍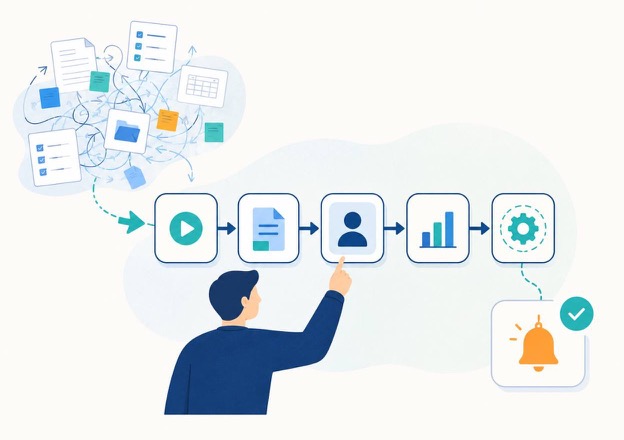
AI 자동화 전에 업무 흐름부터 그려야 하는 이유
AI 자동화 전에 업무 흐름부터 그려야 하는 이유AI 자동화를 시작하면 새로운 도구부터 찾기 쉽습니다. 하지만 제가 먼저 자동화한 것은 개발 작업 자체가 아니었습니다. AI에게 작업을 맡긴 뒤 각 터미널을 돌아다니며 상태를 확인하는 행동이었습니다. 자동화하기 전, 일곱 개 터미널을 확인했습니다저는 평소 Windows에서 Claude Code CLI를 이용해 개발합니다. 작업이 많을 때는 서로 다른 프로젝트를 진행하는 터미널을 최대 7개까지 동시에 열어 두기도 했습니다. Claude가 긴 작업을 수행하는 동안 다른 일을 할 수 있다는 것이 CLI 에이전트의 장점입니다. 그러나 실제로는 하던 일을 멈추고 각 터미널을 열어 작업이 끝났는지, 권한이나 추가 입력이 필요한지 확인했습니다. 너무 자주 확인하면 현재 업무의 흐름이 끊겼고, 늦게 확인하면 Claude가 입력을 기다리는 동안 작업도 멈춰 있었습니다. 당시의 흐름은 다음과 같았습니다. 작업 요청 → 다른 업무 진행 → 여러 터미널을 반복 확인 → 선택 또는 입력 → 결과 검수 제가 자동화해야 했던 것은 AI의 개발 작업이 아니라, 사람이 다시 개입할 시점을 확인하는 일이었습니다. 자동화한 것은 AI가 아니라 다시 개입할 시점입니다먼저 어떤 순간에 제가 터미널로 돌아가야 하는지 정했습니다. Claude Code의 훅 중에서 권한이나 사용자 입력이 필요할 때 발생하는 Notification, 메인 에이전트의 응답이 끝날 때 발생하는 Stop, 서브에이전트의 작업이 끝날 때 발생하는 SubagentStop을 기준으로 삼았습니다. 알림을 적용한 뒤의 흐름은 이렇게 바뀌었습니다. 작업 요청 → 다른 업무 진행 → 입력 요청 또는 완료 알림 → 해당 터미널로 복귀 → 선택·입력 또는 결과 검수 알림이 작업의 결과를 대신 판단하지는 않습니다. 선택지가 주어지면 제가 결정하고, 추가 정보가 필요하면 직접 입력합니다. 작업이 끝났을 때도 해당 터미널로 돌아가 결과를 검수합니다. 자동화가 맡은 역할은 사람이 필요한 순간을 알려주는 것까지입니다. 훅과 프로젝트명을 먼저 정했습니다동시에 실행한 터미널이 많았기 때문에 단순히 “작업이 완료되었습니다”라는 알림만으로는 부족했습니다. 알림을 보고 어느 터미널로 돌아가야 하는지 바로 알 수 있어야 했습니다. 그래서 현재 작업 경로의 마지막 폴더명을 프로젝트명으로 사용했습니다. 알림 제목을 Claude · 프로젝트명으로 표시하니 여러 세션 중 확인할 작업을 구분할 수 있었습니다. 첫 알림은 AI의 도움을 받아 30분 안에 구현했습니다. Windows용 PowerShell 훅은 현재 작업 경로에서 프로젝트명을 가져오고, 이벤트에 따라 알림 내용을 나누도록 만들었습니다. Notification에는 사람이 확인해야 할 요청을, Stop과 SubagentStop에는 각각 메인 작업과 서브에이전트의 완료 여부를 표시했습니다. 알 수 없는 이벤트나 잘못된 입력은 본래 작업을 방해하지 않도록 조용히 종료하게 했습니다. 화려한 기능보다 언제 알릴지와 어느 프로젝트인지를 정하는 것이 이 자동화의 핵심이었습니다. 동료가 바로 설치할 수 있도록 Windows용 압축 파일로 정리했습니다개인적으로 사용하던 알림을 동료에게도 공유하기 위해 Windows용 압축 파일로 정리했습니다. Claude Code 알림 스크립트와 더블 클릭으로 실행하는 설치 파일, 기존 설정 백업과 문제 해결 방법을 하나의 압축 파일에 담았습니다. 지원한다고 해서 모든 이벤트를 기본으로 활성화하지는 않았습니다. 서브에이전트는 한 작업에서도 여러 번 끝날 수 있어 SubagentStop까지 기본 등록하면 오히려 알림이 지나치게 많아질 수 있었습니다. 그래서 설치 과정에서는 입력 요청을 받는 Notification과 메인 작업 완료를 알리는 Stop만 기본으로 등록했습니다. 5월 28일에 공유한 뒤 현재까지 저와 동료들이 실제 업무에서 사용하고 있습니다. 이제 작업이 끝났는지 확인하려고 여러 터미널을 돌아다니지 않습니다. 알림이 올 때까지 현재 업무에 더 집중하고, 사람의 판단이 필요한 순간에만 해당 터미널로 돌아갑니다. 공유받은 동료는 별도의 코드 수정 없이 설치했습니다. 작은 개인용 스크립트도 다른 사람이 설치하고 되돌릴 수 있는 형태로 정리해야 재사용 가능한 도구가 된다는 점을 확인했습니다. 개인 맥북에서도 같은 흐름을 유지했습니다이후 개인적으로 사용하는 맥북에서도 같은 흐름을 유지하고 싶어 Python으로 확장했습니다. 훅의 종류와 프로젝트명 표시 방식은 Windows에서 사용하던 기준을 그대로 적용했습니다. macOS에서는 terminal-notifier가 설치되어 있으면 이를 사용하고, 없으면 기본 osascript 알림으로 대체합니다. 특정 알림 도구가 없어도 핵심 흐름은 계속 동작하도록 한 것입니다. 운영체제가 바뀌어도 제가 원하는 결과는 같았습니다. 알림을 기다리며 다른 업무에 집중하고, 사람의 판단이나 검수가 필요한 순간에만 해당 터미널로 돌아가는 것입니다. 공식 기능이 충분해지면 중단할 생각입니다일론 머스크는 2021년 Everyday Astronaut 인터뷰에서 요구사항을 의심하고 불필요한 단계를 삭제한 뒤 단순화·최적화하고, 마지막에 자동화하라고 설명했습니다. 제 사례에서도 먼저 살펴본 것은 새로운 도구가 아니라 반복해서 터미널을 확인하던 업무 흐름이었습니다. 현재 이 알림은 여러 터미널을 반복 확인하는 일을 없애 주기 때문에 유지하고 있습니다. 반대로 Claude Code가 프로젝트 구분과 입력 요청까지 충분히 알려주는 공식 기능을 제공한다면 직접 만든 알림은 중단할 생각입니다. 유지보수할 이유가 사라지기 때문입니다. 이 사례를 다른 업무에 적용할 때는 반복해서 확인하는 행동, 사람이 다시 개입해야 하는 조건, 결과를 검수할 지점을 순서대로 적어 보세요. 그중 사람의 판단은 필요하지 않지만 상태를 계속 확인해야 하는 단계가 작은 자동화의 후보입니다. 좋은 자동화는 복잡한 기술의 크기로 결정되지 않습니다. 반복되는 흐름에서 무엇을 없애고, 어느 순간에 사람의 판단을 남길지 정하는 것이 먼저입니다. 자동화 도구를 열기 전에 이번 주에 집중을 끊고 반복해서 확인한 순간부터 적어 보세요.
정상운