
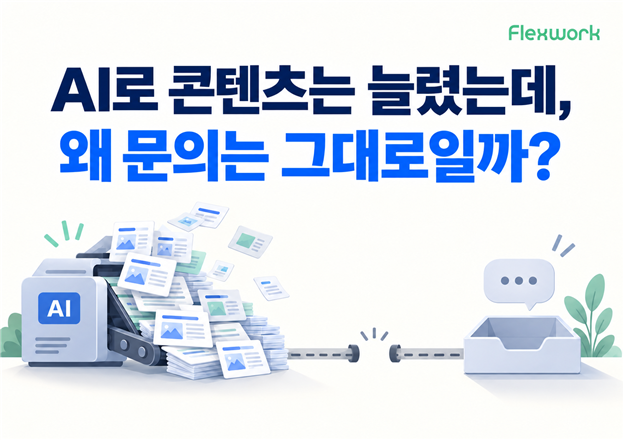
AI로 콘텐츠는 늘렸는데, 왜 인바운드 문의 수는 그대로일까?
AI로 콘텐츠는 늘렸는데, 왜 문의는 그대로일까? AI로 주제를 뽑고 초안을 쓰면서 콘텐츠 제작 속도는 빨라졌습니다. 그런데 발행량을 늘려도 문의나 데모 요청이 그대로라면, 다음에는 무엇을 만들어야 할까요? 먼저 확인할 질문이 있습니다. “지금 만드는 콘텐츠는 고객의 어떤 구매 고민을 해결하고 있는가?” 제품의 필요성을 설명하는 글을 다섯 편 더 만들어도, 고객이 망설이는 이유가 “기존 시스템과 연동할 수 있을까?”라면 필요한 답은 여전히 비어 있습니다. 물론 문의에는 유입 규모, 방문자 구성, 제품 수요도 영향을 줍니다. 그중 B2B 마케팅팀이 기존 콘텐츠에서 점검할 수 있는 세 가지를 살펴보겠습니다. 1. 고객이 검토를 멈추는 질문에 답하고 있는가콘텐츠를 주제나 형식으로만 분류하지 말고, 각 콘텐츠가 답하는 고객 질문을 한 문장으로 적어보세요. “이 문제를 지금 해결해야 할까?” “다른 대안과 무엇이 다를까?” “우리 환경에서 도입할 수 있을까?” 같은 질문에 답하는 글만 반복된다면, 아직 다루지 않은 구매 고민이 있는지 확인해야 합니다. 문제의 중요성을 설명하는 콘텐츠는 충분한데 도입 절차에 대한 자료가 없다면, 다음 기획은 그 공백에서 시작할 수 있습니다. 2. 실제 상담에서 공유할 만큼 구체적인가영업팀에 “최근 고객이 반복해서 물은 질문”과 “내부 승인을 위해 요청한 자료”를 물어보세요. 상담 기록이 많다면 AI로 반복 질문을 먼저 묶고, 담당자가 맥락과 우선순위를 확인할 수 있습니다. 이후 기존 콘텐츠가 그 질문에 충분히 답하는지 살펴봅니다. 예를 들어 “기존 도구와 연동되나요?”라는 질문에 “다양한 연동 지원”이라는 문구만으로는 부족할 수 있습니다. 고객에게는 지원 도구, 준비 사항, 담당자가 해야 할 작업이 필요합니다. 관련 내용이 있는지보다, 고객이 그 자료로 판단할 수 있는지가 중요합니다. 설명이 부족하다면 새 글을 쓰기 전에 기존 글을 보완하거나 FAQ로 정리해보세요. 3. 읽은 뒤 다음 행동이 연결되어 있는가모든 콘텐츠가 곧바로 데모 요청으로 이어질 필요는 없습니다. 문제를 파악하는 독자에게는 체크리스트가, 대안을 비교하는 독자에게는 비교 자료가, 도입을 검토하는 독자에게는 상담 안내가 적절할 수 있습니다. 콘텐츠마다 다음 문장을 완성해보세요. “이 글을 읽은 사람은 ______을 판단하기 위해 ______을 확인하면 된다.” 문장을 쓰기 어렵다면 콘텐츠의 목적을 다시 살펴보세요. 연결할 자료가 없다면 그 자료가 다음 제작 후보입니다. 콘텐츠 5개, 고객 질문 3개로 시작하세요최근 발행한 콘텐츠 5개와 상담에서 반복된 구매 질문 3개를 대조해보세요. 빠진 답, 부족한 설명, 끊긴 연결 중 가장 먼저 보완할 것 하나를 고르면 됩니다. 보완 후 확인할 변화도 정해두세요. 연결 자료 클릭, 상담 신청, 영업팀의 자료 활용 여부 등을 살펴보고, 문의 수는 유입량 변화와 함께 확인합니다. 분석과 제작에 투입할 여력이 부족하다면 외부 전문가와 협업할 수도 있습니다. ‘콘텐츠 마케팅’처럼 넓게 맡기기보다 ‘상담 질문 분석과 도입 FAQ 초안 작성’처럼 과업을 구체화하면 필요한 전문성과 산출물이 명확해집니다. AI로 더 많이 만들 수 있게 됐을수록, 무엇에 답할지 정하는 일이 중요합니다. 다음 콘텐츠 회의에서는 이렇게 물어보세요. “고객의 구매 검토에 필요한데, 우리가 아직 답하지 못한 질문은 무엇인가요?” 우리 팀에 필요한 전문가 찾기
 플렉스웍
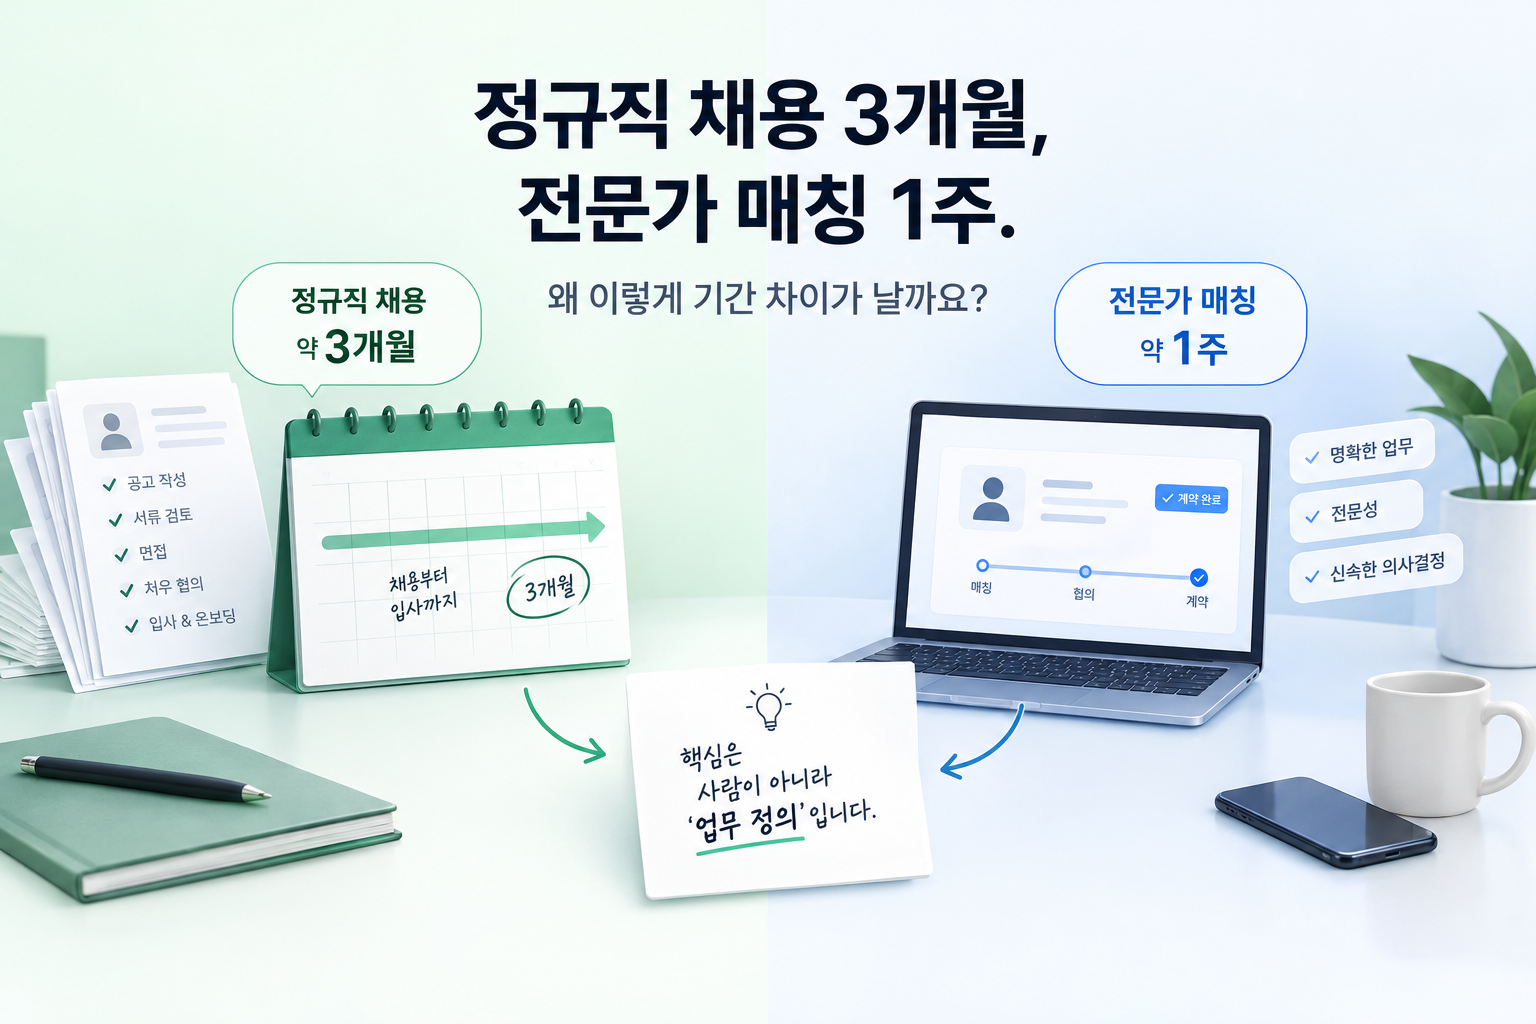
정규직 채용 3개월, 전문가 매칭 1주. 왜 이렇게 기간 차이가 날까요?
정규직 채용 3개월, 전문가 매칭 1주. 왜 이렇게 기간 차이가 날까요? 정규직 채용에 3개월이 걸리는 상황. 플렉스웍에서 전문가 매칭 후 1주 내 계약까지 진행된 실제 사례. 둘의 차이는 단순히 “누가 더 빨리 사람을 구했는가”가 아닙니다. 출발점이 다릅니다. 시간제 전문가를 매칭하는 법이 궁금하다면? -> 자세히 보기 정규직 채용은 한 사람이 맡을 직무 전체를 찾습니다. 반면 전문가 협업은 지금 해결해야 할 업무 하나에서 시작합니다. 역할, 기간, 결과물이 선명할수록 탐색과 의사결정은 짧아질 수 있습니다. 물론 ‘3개월’과 ‘1주’는 평균도, 모든 기업에 적용되는 보장도 아닙니다. 3개월은 채용이 수개월 이어지는 대표적인 상황을 보여주는 숫자이고, 1주는 플렉스웍에서 실제로 계약까지 진행된 사례입니다. 이 글에서는 세 가지를 빠르게 구분합니다. 언제 정규직을 채용해야 하는가 언제 외부 전문가와 협업해야 하는가 언제 내부 담당자와 전문가를 결합해야 하는가 핵심은 사람을 급히 찾는 것이 아닙니다. 채용 전에, 일부터 정의하는 것입니다. 채용이 길어지는 동안에도 업무 공백 비용은 쌓입니다정규직 채용은 신중해야 합니다. 역할을 정의하고, 공고를 내고, 지원자를 평가하고, 처우와 입사 일정을 협의한 뒤 온보딩까지 거쳐야 합니다. 조직의 핵심 역할을 오래 맡길 사람이라면 이 과정은 필요합니다. 문제는 채용 기간이 아니라, 그동안 멈춰 있는 일입니다. 콘텐츠 전략이 비어 있고, CRM 설계가 미뤄지고, 데이터 정리가 쌓이고, 자동화 과제가 담당자 없이 떠돈다면 조직은 매주 비용을 치릅니다. 매출 기회를 놓치고, 기존 팀의 부담이 커지고, 중요한 의사결정이 늦어집니다. 이럴 때 질문을 바꿔야 합니다. “누구를 채용할까?”가 아니라 “지금 어떤 일을 끝내야 할까?” 직무 전체가 아니라 당장 필요한 업무를 분리하면 필요한 전문성, 수행 기간, 산출물, 완료 기준이 보입니다. 그제야 정규직 채용이 맞는지, 전문가 협업이 맞는지 판단할 수 있습니다. 정규직이 맞는 일은 분명합니다다음과 같은 역할은 정규직 채용을 우선 검토하는 편이 적합합니다. 장기간 반복되며 회사의 핵심 운영과 연결되는 일 내부 의사결정과 여러 부서의 맥락을 깊이 이해해야 하는 일 고객, 데이터, 계약 등에 상시 책임을 져야 하는 일 지식과 관계를 조직 안에 지속적으로 축적해야 하는 일 상황에 따라 업무 범위가 계속 달라지는 역할 제품 책임자, 사업 운영 담당자, 핵심 고객 관리 담당자처럼 장기적인 판단과 관계 형성이 중요한 자리는 단기 산출물만으로 평가하기 어렵습니다. 이런 역할에는 충분한 채용과 온보딩 시간이 필요합니다. 정규직 채용이 느려서 잘못된 것이 아닙니다. 오래 함께할 역할을 고르는 방식이기 때문에 신중한 것입니다. 전문가 협업은 ‘명확한 업무’에서 빨라집니다반면 다음 조건에 가까운 일은 외부 전문가 협업을 검토할 수 있습니다. 시작과 종료 시점을 정할 수 있다 필요한 산출물과 완료 기준을 설명할 수 있다 특정 분야나 도구의 전문성이 필요하다 내부 팀에 경험이 없거나 당장 수행할 여력이 없다 장기 직무를 만들기 전에 작은 범위로 검증하고 싶다 특정 시기에 업무량이 집중된다 콘텐츠 전략 수립, 광고 계정 진단, CRM 시나리오 설계, 데이터 정리, 업무 자동화 구축처럼 결과물을 구체화할 수 있는 과업이 대표적입니다. 단, 업무를 외부에 맡긴다고 책임까지 사라지는 것은 아닙니다. 특히 재무·세무처럼 자격이나 법적 책임이 필요한 영역은 자료 준비와 실무 지원의 범위, 최종 신고와 책임의 주체를 계약 전에 분명히 해야 합니다. 3개월 vs 1주, 속도를 가른 것은 ‘채용 기술’이 아니라 ‘업무 정의’입니다다시 숫자로 돌아가 보겠습니다. 3개월: 정규직 채용이 수개월 이어질 수 있는 대표적인 상황 1주: 플렉스웍에서 전문가 매칭 후 실제 계약까지 진행된 사례 이 차이를 모든 프로젝트의 결과로 일반화할 수는 없습니다. 그러나 한 가지는 분명합니다. 사람의 직무 전체를 찾는 것보다, 해결할 업무와 완료 기준을 먼저 정한 뒤 그 범위에 맞는 전문가를 찾을 때 의사결정 단계는 줄어들 수 있습니다. 빠른 계약의 전제는 “좋은 사람을 빨리 추천받는 것”만이 아닙니다. 무엇을, 언제까지, 어떤 기준으로 끝낼지 먼저 합의하는 것. 업무가 모호하면 전문가 매칭도 느려집니다. 반대로 업무가 선명하면 후보 검토, 역량 확인, 계약 범위 조율이 빨라질 수 있습니다. 둘 중 하나만 고를 필요는 없습니다실무에서는 정규직과 전문가를 결합한 혼합형이 유효할 때가 많습니다. 내부 담당자는 목표, 우선순위, 브랜드 기준, 예산, 최종 승인을 맡습니다. 외부 전문가는 명확히 나눈 과업을 수행합니다. 예를 들어 내부 마케팅 담당자가 방향을 관리하고, 콘텐츠 제작·광고 분석·CRM 설계를 각 분야 전문가와 진행하는 방식입니다. 혼합형의 핵심은 단순한 업무 분배가 아닙니다. 책임의 경계를 설계하는 것입니다. 내부 의사결정자와 실무 담당자를 정한다 전문가가 맡을 범위와 제외 범위를 문서화한다 중간 검토 시점과 최종 승인 절차를 정한다 계정과 데이터 접근 권한을 필요한 만큼만 부여한다 결과물과 작업 방법을 조직 내부에 남긴다 이 구조라면 내부 팀은 핵심 판단을 유지하면서도, 필요한 전문성을 특정 업무에 집중할 수 있습니다. AI 도구 이름보다 실제 수행 방식을 확인해야 합니다AI를 쓸 줄 안다는 말만으로는 부족합니다. 도구를 아는 것과 업무를 끝내는 것은 다르기 때문입니다. 플렉스웍은 매칭 전에 실제 업무와 가까운 실무 퀘스트를 통해 수행 방식을 확인합니다. 핵심은 다음 다섯 가지입니다. 문제 정의: 목표, 제약 조건, 필요한 결과물을 제대로 정리하는가 도구 활용: 업무에 맞는 AI 도구를 선택하고 수정 과정을 설계하는가 정확성: 사실관계, 계산, 문맥, 형식의 오류를 점검하는가 사람의 검수: AI 결과를 그대로 제출하지 않고 판단과 수정을 더하는가 보안과 문서화: 민감 정보를 안전하게 다루고 작업 근거와 인계 사항을 남기는가 검증 방식도 실제 맡길 일과 가까워야 합니다. 콘텐츠 업무라면 독자와 메시지의 일관성을, 데이터 업무라면 계산 기준과 재현 가능성을 봐야 합니다. 모든 전문가에게 같은 시험을 적용하는 것보다 실제 과업에 맞춘 확인이 중요합니다. 협업 전, 여섯 가지만 정하면 됩니다긴 요구사항 문서부터 만들 필요는 없습니다. 아래 질문에 먼저 답해 보세요. 지금 반드시 해결해야 할 문제는 무엇인가? 최종 결과물은 무엇인가? 언제까지 완료해야 하는가? 완료 여부를 어떤 기준으로 판단할 것인가? 내부 최종 의사결정자는 누구인가? 공유 가능한 정보와 제한해야 할 권한은 무엇인가? 이 여섯 가지가 정리되면 선택도 단순해집니다. 장기적인 핵심 역할과 내부 지식 축적이 중요하다면: 정규직 기간과 결과물이 명확하고 특정 전문성이 필요하다면: 전문가 협업 내부 판단은 유지하면서 일부 과업에 전문성이 필요하다면: 혼합형 채용 전에 일부터 정의해야 하는 이유직무부터 만들면 서로 다른 요구가 한 사람에게 쌓이기 쉽습니다. 전략도, 실행도, 분석도, 자동화도 모두 잘하는 사람을 찾다가 채용은 길어지고 업무는 계속 밀립니다. 반대로 일을 먼저 나누면 선택지가 보입니다. 내부에 오래 남겨야 할 역할은 정규직으로 채용하고, 지금 끝내야 할 과업은 전문가와 진행하며, 최종 판단은 내부 담당자가 맡을 수 있습니다. 정규직과 전문가 협업은 대체 관계가 아니라 업무 성격에 따라 조합하는 선택지입니다. 정규직 채용 3개월, 전문가 계약 1주. 이 숫자의 목적은 무조건 빠른 방식을 고르라는 데 있지 않습니다. 채용에 수개월이 필요한 상황이라면 그동안의 업무 공백을 당연하게 받아들이지 말자는 뜻입니다. 플렉스웍에서는 업무 범위가 명확한 경우 전문가 매칭 후 실제로 1주 내 계약까지 진행된 사례가 있습니다. 지금 필요한 것이 장기 역할인지, 당장 끝내야 할 업무인지부터 구분해 보세요.
플렉스웍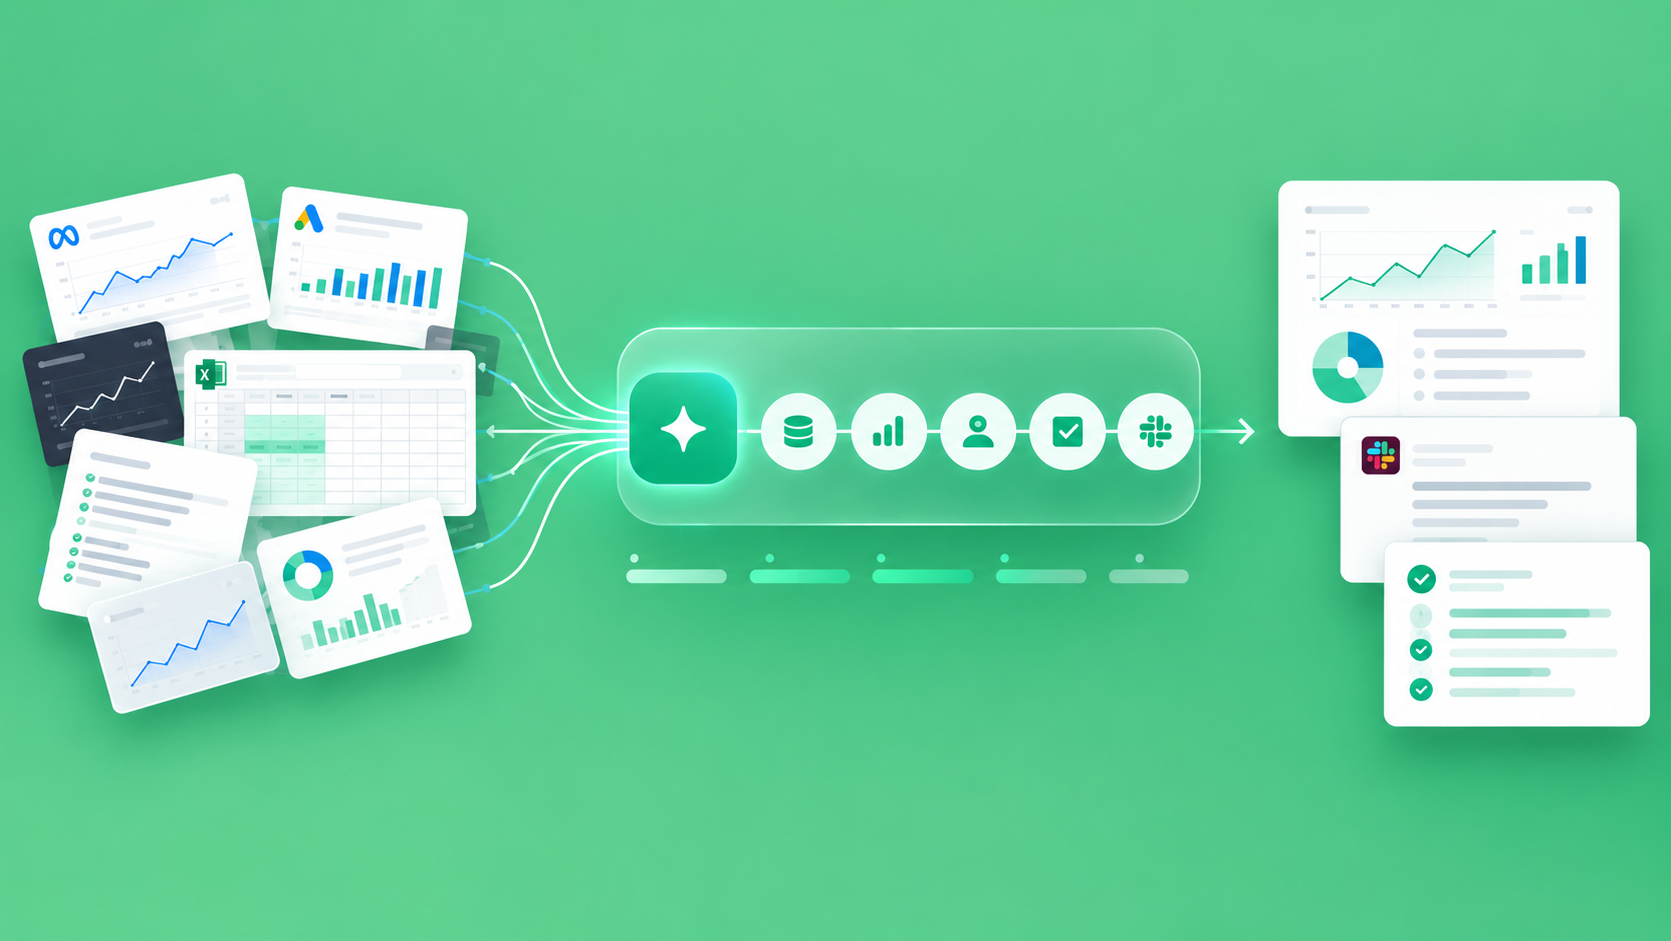
광고 성과 리포트 자동화, 매주 반복하던 일을 Agent 워크플로우로 바꾸는 법
Meta 확인 → Excel 취합 → 분석 → 보고 → Slack 공유. 이 루틴, 낯익지 않나요? 월요일 아침, 마케터 A는 Meta 광고 관리자를 엽니다. 지난주 기간을 선택해 데이터를 내려받고, Excel의 기존 탭을 복사합니다. 열 순서와 기간을 맞춘 뒤 빈 값이 없는지 확인합니다. 캠페인별 변화를 분류하고 보고 문장을 다듬어 Slack에 올립니다. A는 분석할 줄 모르는 사람이 아닙니다. 오히려 업무에 익숙하기 때문에 어긋난 숫자와 이상한 흐름을 빨리 발견합니다. 문제는 그 판단에 도달하기 전까지 데이터를 찾고, 옮기고, 맞추는 일을 매주 되풀이한다는 데 있습니다. 이 업무는 정말 ‘판단 업무’일까요?주간 리포트에는 사람의 판단이 필요합니다. 다만 처음부터 끝까지 모든 단계가 판단 업무인 것은 아닙니다. A가 캠페인별 증감에 색을 칠한다고 해보겠습니다. 그 색을 칠하는 기준이 이미 정해져 있다면, 매번 새롭게 생각해야 하는 일이 아니라 합의된 규칙을 반복 적용하는 일에 가깝습니다. 아래 항목으로 현재 업무를 확인해 보세요. [ ] 매주 또는 매월 정해진 시점에 같은 업무가 시작된다. — 정기성 [ ] 둘 이상의 화면·파일·표에서 데이터를 가져와 한 형식으로 맞춘다. — 데이터 취합 [ ] 목표 대비, 전주 대비, 임계값, 상태값처럼 정해진 기준으로 항목을 나눈다. — 정해진 기준의 분류 [ ] 결과를 공유하기 전에 사람이 누락과 예외를 반복 확인한다. [ ] 최종 보고 형식과 공유 채널이 대부분 정해져 있다. 첫 세 항목이 모두 해당된다면, 보고서를 빨리 쓰는 요령보다 반복 구간을 어떻게 연결할지 먼저 살펴볼 필요가 있습니다. 마지막 두 항목은 사람이 확인할 지점과 예외 처리 방식을 정할 때 쓰는 질문입니다. 자동화 도구를 써도 왜 다음 주에 같은 일을 다시 할까요?A도 Excel 함수와 대시보드를 사용합니다. GPT나 Claude에 CSV를 넣고 요약문을 만들어 본 적도 있습니다. 비정기 분석이나 초안을 만들 때 이런 도구는 분명 유용합니다. 그런데 다음 주 월요일이 되면 A는 지난 대화를 찾고, 새 CSV를 준비하고, 지표의 의미와 원하는 출력 형식을 다시 설명합니다. 답변을 받은 뒤에는 보고서에 옮기고 Slack에 공유해야 합니다. 도구가 부족해서가 아니라 업무의 앞뒤가 연결되지 않았기 때문입니다. 반복의 원인은 ‘설계 부재’에 있습니다. 언제 업무를 시작할지, 어느 데이터에 연결할지, 어떤 규칙으로 분류할지, 오류를 어떤 상태로 남길지, 누가 승인할지, 승인 뒤 무엇을 기록할지가 하나의 흐름으로 정리되지 않은 것입니다. 이 연결이 없으면 좋은 모델을 써도 담당자가 매주 작업을 다시 시작합니다. 단발성 GPT·Claude 사용과 Agent 워크플로우의 차이는 모델의 우열이 아닙니다. 단발성 사용에서는 담당자가 파일을 찾고 프롬프트를 입력해야 업무가 시작됩니다. 대화가 끝나면 실행 성공 여부, 누락, 승인 대기 같은 상태가 다음 주까지 이어지지 않을 수 있습니다. Agent 워크플로우에서는 정해진 시각이나 승인된 데이터 갱신을 시작 신호로 삼습니다. 데이터 연결, 분류 규칙, 예외 상태, 담당자 승인, 후속 기록이 한 흐름 안에 놓입니다. Agent를 도입한다는 말은 챗봇을 하나 더 추가한다는 뜻이 아닙니다. 반복 업무가 매번 같은 조건과 규칙으로 이어지도록 구조를 만드는 일에 가깝습니다. Agent가 들어오면 월요일 아침은 어떻게 달라질까요?가상의 회사가 주간 리포트 흐름을 바꾼다면 핵심은 다음과 같습니다. Meta API → Agent 분석 → 담당자 판단 → Next Action 여기서 ‘Agent 분석’은 성과 변화의 원인을 확정한다는 뜻이 아닙니다. 승인된 데이터를 불러와 정해진 형식으로 맞추고, 합의된 규칙에 따라 검토 순서를 나누며, 이상 신호와 원인 후보를 제시하는 단계입니다. 실제 흐름을 조금 더 자세히 보면 이렇습니다. 정해진 주간 리포트 시각이나 승인된 데이터 갱신이 트리거가 됩니다. Agent는 Meta API를 통해 필요한 기간과 범위의 승인된 지표를 불러옵니다. 지표명, 기간, 단위, 캠페인 식별자를 보고 형식에 맞게 정리합니다. 전주 대비, 목표 대비 등 사전에 합의한 기준으로 검토 우선순위를 분류합니다. 누락이나 급격한 변화를 발견하면 결론을 내리지 않고 ‘확인 필요’ 신호와 근거를 남깁니다. 담당자는 데이터의 완전성과 업무 맥락을 확인하고, 원인 가설과 보고 문구를 승인하거나 수정하거나 보류합니다. 승인된 조치는 Next Action으로 전환되어 담당자, 기한, 이후 확인할 지표와 함께 기록됩니다. 승인된 요약과 링크만 Slack에 공유합니다. 이 구조가 작동하려면 실제 구축 전에 API 접근 권한, 데이터 스키마, 지표 정의, 분류 규칙과 승인자를 정해야 합니다. 인증에 실패하면 보고서를 억지로 만들지 않고 연결 확인 요청을 남겨야 합니다. 데이터 일부가 비어 있다면 정상 결과와 섞어 확정하지 않고 검토 대기로 분리해야 합니다. 담당자가 승인하지 않은 예산 변경이나 최종 공유도 진행하지 않습니다. Agent는 만능 자동화가 아닙니다. 잘 설계된 Agent는 오류와 예외를 감추지 않고 사람이 확인할 수 있는 상태로 드러냅니다. 무엇을 Agent에 맡기고, 무엇을 사람이 결정해야 할까요?월요일 아침의 A는 더 이상 빈 Excel에서 보고서를 조립하는 것으로 업무를 시작하지 않습니다. Agent가 준비한 검토 화면에서 누락 경고, 주요 변화, 분류 근거를 먼저 봅니다. 그리고 “왜 이런 변화가 생겼는가”, “무엇을 바꿀 것인가”에 집중합니다. 그렇다면 A의 일이 사라진 걸까요? 그렇지 않습니다. A가 하던 일 가운데 찾고, 옮기고, 맞추는 일이 Agent 쪽으로 이동하고, 책임 있는 판단이 업무의 앞쪽에 놓인 것입니다. Agent에 맡길 수 있는 반복은 다음과 같습니다. 정해진 시점에 승인된 데이터를 호출하는 일 지표명, 기간, 단위를 보고 형식에 맞추는 일 합의된 기준에 따라 검토 우선순위를 나누는 일 누락과 이상 신호 후보를 표시하는 일 보고 초안과 검토 항목을 준비하는 일 승인된 후속 행동을 기록하고 공유하는 일 사람에게 남겨야 할 판단은 분명합니다. 성과 변화의 실제 원인을 해석하는 일 시장 상황, 프로모션, 소재 맥락을 함께 보는 일 예산을 유지하거나 변경하거나 중단할지 결정하는 일 어떤 메시지와 소재를 선택할지 정하는 일 팀 리더와 관련 부서의 우선순위와 위험을 조율하는 일 기존 기준을 바꾸거나 예외를 승인하는 일 원칙은 간단합니다. 반복은 Agent, 판단은 사람. Agent가 검토 가능한 상태를 만들고, 사람은 결과에 책임을 지는 결정을 내립니다. Before와 After의 업무 흐름은 무엇이 다를까요?Before의 A는 업무가 시작된 뒤 각 화면에 접속합니다. 파일을 내려받아 열을 맞추고, 누락과 기간 오류를 찾습니다. 기준표와 지난 보고서를 다시 확인해 상태를 분류한 뒤 문장을 작성합니다. 리더의 수정 의견이 오면 문서에 다시 반영하고 Slack에 올립니다. 후속 조치는 별도 메시지나 A의 기억에 남기도 합니다. After에서는 보고 시각 전에 정해진 트리거가 데이터 수집과 정규화를 시작합니다. 실패, 누락, 이상 신호는 근거와 함께 검토 대기로 모입니다. A는 준비된 비교와 분류 근거를 확인한 뒤 원인을 해석하고 예산, 메시지, 우선순위를 승인하거나 수정합니다. 승인된 결과는 Next Action으로 이어지고, 담당자와 기한, 이후 확인할 지표가 남습니다. 최종 요약과 링크는 승인 뒤 Slack에 공유됩니다. 다음 실행에서는 이전 상태와 끝나지 않은 조치도 다시 확인할 수 있습니다. 달라지는 것은 막연한 ‘속도’만이 아닙니다. 업무 시작점이 빈 Excel에서 검토 가능한 상태로 바뀝니다. 오류를 최종 문서 작성 중 발견하는 대신 수집·정리 단계에서 별도 상태로 확인합니다. 리더는 완성 문장 전체를 되돌려 보기보다 판단이 필요한 항목을 중심으로 검토합니다. 후속 조치는 대화 속에 흩어지지 않고 담당자, 기한, 확인 지표와 연결됩니다. A는 데이터 운반보다 원인 해석과 실행 우선순위에 집중합니다. 이 변화가 저절로 생기는 것은 아닙니다. 트리거와 데이터 연결만 설정해 놓고 승인 규칙과 오류 상태를 비워 두면, 담당자는 결과 전체를 다시 검사하게 됩니다. Agent의 범위를 정할 때 정상 흐름보다 실패했을 때 멈추는 조건을 먼저 적어두는 편이 좋습니다. 우리 업무도 Agent로 바꿀 수 있을까요?모델이나 도구를 고르기 전에 현재 업무를 한 장에 그려보세요. 아래 질문에 답하면 어디까지 Agent에 맡기고 어디부터 사람이 책임질지 구체적으로 정할 수 있습니다. 이 업무는 무엇을 계기로 시작되나요? 필요한 데이터는 어디에 있고 접근 권한은 어떻게 관리되나요? 반복 적용할 수 있는 분류 기준은 무엇인가요? 누락, 오류, 기준 밖 변화는 어떤 상태로 구분해야 하나요? 사람이 반드시 확인하고 승인해야 하는 지점은 어디인가요? 승인 뒤 어떤 Next Action을 누구에게 어떤 형식으로 남겨야 하나요? 다음 실행에서 참고해야 할 이전 상태는 무엇인가요? 답이 모이면 “Agent가 알아서 처리해 주세요”라는 모호한 요청 대신, 수집·분류·검토·승인·공유 중 어디부터 바꿀지 범위를 정할 수 있습니다. 처음부터 모든 단계를 연결할 필요도 없습니다. 기준이 분명하고 오류를 확인하기 쉬운 반복 구간부터 시작해 사람의 승인 지점을 붙이는 방법도 있습니다. Flexwork는 실제 업무 문제를 기준으로 AI 시대형 전문가와 프로젝트·시간제 협업·커뮤니티·전문가 기회를 연결하는 전문가 네트워크입니다. 매주 되풀이되는 보고 업무가 있다면, 도구를 고르기 전에 시작 조건과 데이터 흐름, 분류 기준, 사람의 승인 지점, 후속 행동을 먼저 적어보세요. 어디가 반복이고 어디가 판단인지 구분되면 Agent로 바꿀 범위도 선명해집니다. 우리 업무 Agent로 바꿔보기
플렉스웍
AI 시대 인력 운영, 정규직 대신 스페셜리스트가 뜨는 이유
새로운 업무가 생기면 사람을 뽑는 것. 오랫동안 기업의 가장 자연스러운 인력 운영 방식이었습니다. 마케팅이 필요하면 마케터를 채용하고, 개발이 필요하면 개발자를 채용합니다. 조직 안에 필요한 역량을 최대한 많이 갖추는 것이 좋은 조직을 만드는 방법이라고 생각했기 때문입니다. 하지만 AI가 업무의 많은 부분을 빠르게 처리하기 시작하면서, 이 방식에도 변화가 나타나고 있습니다. 기업이 원하는 것은 단순히 '일을 할 수 있는 사람'이 아니라, 지금 우리에게 필요한 문제를 빠르게 해결할 수 있는 사람이 되고 있기 때문입니다. 실제 시장의 숫자도 이 변화를 보여줍니다. 숙련된 사람일수록, 조직 밖에서 일하기 시작했습니다Upwork의 Future Workforce Index 2026(2,400명의 미국 숙련 지식근로자 대상 조사)에 따르면, 숙련 지식근로자 중 프리랜서·독립 전문가로 일하는 비중은 1년 사이 28%에서 38%로 증가했습니다. 10명 중 약 4명이 이미 전통적인 정규직 형태만으로 일하지 않는 셈입니다. 더 흥미로운 건 AI와의 결합입니다. 같은 조사에서 AI를 업무에 결합한 프리랜서는 그렇지 않은 프리랜서보다 시간당 34% 더 높은 수익을 올렸습니다. AI가 사람의 역할을 없애는 것이 아니라, 전문성을 가진 사람이 AI를 활용해 더 높은 수준의 일을 수행하는 방식이 빠르게 확산되고 있는 것입니다. 이 변화는 프리랜서 시장의 성장에 그치지 않습니다. Fractional Jobs의 2026 리포트에 따르면, fractional 인력에 대한 채용 수요는 전년 대비 149% 증가했습니다. 더 눈여겨볼 숫자는, fractional 인력의 87%가 11년 이상의 경력을 가지고 있었다는 점입니다. 기업이 외부에서 활용하는 인력은 단순 보조 인력이 아니라, 오랜 경험을 가진 전문가라는 의미입니다. 이제 기업은 모든 전문성을 정규직으로 보유하지 않아도 됩니다. 필요한 순간에, 필요한 경험을 가진 사람과 연결하면 됩니다. AI는 왜 스페셜리스트의 필요성을 오히려 키우는가AI가 발전하면 사람의 전문성이 덜 중요해질 거라 생각하기 쉽습니다. 하지만 실제로는 반대 방향의 변화도 나타나고 있습니다. AI가 실행을 빠르게 만들어줄수록, 무엇을 해야 하는지 판단하는 전문성의 중요성이 커지기 때문입니다. AI에게 콘텐츠를 작성하게 하는 것과, B2B 고객에게 어떤 콘텐츠를 어떤 채널·순서로 제공할지 설계하는 것은 전혀 다른 문제입니다. AI로 데이터를 정리하는 것과, 어떤 데이터를 모아 어떻게 연결해야 비즈니스 의사결정에 쓸 수 있는지 설계하는 것도 다릅니다. 기업이 필요로 하는 것은 이제 직함보다 특정 문제를 해결해본 경험에 가까워지고 있습니다. '마케터 한 명'이 아니라 'B2B SaaS의 GTM을 만들어본 사람', '개발자 한 명'이 아니라 'AI 엔지니어링을 실제로 운영해본 사람'이 필요한 시대입니다. AI가 실행을 대신할수록, 사람에게 남는 일은 점점 더 판단, 설계, 전문성, 책임에 가까워집니다. Generalist 한 명이 여러 일을 처리하는 것보다, 특정 문제를 깊이 이해하는 Specialist를 필요한 순간에 연결하는 방식이 더 효율적입니다. 직군별로 보면 더 명확해집니다마케팅 - 콘텐츠 전략, 퍼포먼스 마케팅, CRM, GEO는 이제 서로 다른 전문 영역입니다. 신규 시장 진출을 앞두고 있다면 GTM Specialist를, SEO를 본격적으로 시작한다면 SEO Specialist를 연결하는 방식이 한 사람에게 세 가지를 모두 기대하는 것보다 빠르게 성과를 냅니다. 개발 - 특정 스택, 특정 도메인(AI 엔지니어링, 인프라, 프론트엔드)에 정통한 개발자를 프로젝트 단위로 투입하면, 온보딩 없이 바로 결과물이 나옵니다. PM/UX - AI 네이티브 프로덕트를 만들어본 경험이 있는 스페셜리스트는, 처음부터 다른 관점에서 문제를 설계합니다. 인력 공백 대응 - 육아휴직 등으로 갑자기 생기는 업무 공백도, 정규직을 다시 채용하기보다 그 역할을 즉시 이어받을 수 있는 전문가와의 협업으로 훨씬 빠르게 해결할 수 있습니다. 그래서 필요한 건, Core Team과 Specialist Network외부 전문가와 협업한다고 정규직이 필요 없어지는 건 아닙니다. 핵심은 정규직과 외부 전문가 중 하나를 선택하는 것이 아니라, 두 가지를 함께 활용하는 조직 구조입니다. Core Team은 회사의 방향과 전략을 결정하고, 고객과 제품을 이해하며, 장기적으로 조직에 축적되어야 하는 핵심 업무를 담당합니다. Specialist Network는 특정 프로젝트나 문제를 해결하기 위해 필요한 순간 외부의 전문성을 연결합니다. 프로젝트가 끝나면 다음 문제를 해결할 다른 전문가와 협업하면 됩니다. 과거에는 조직의 역량을 인원수로 설명했습니다. AI 시대에는 필요한 전문성을 얼마나 빠르게 확보할 수 있는지가 새로운 질문이 될 수 있습니다. 지금 우리 조직에 필요한 전문성은 무엇인가요숙련 지식근로자의 프리랜서 비중이 28%에서 38%로 증가한 것도, fractional 인력 채용 수요가 149% 증가한 것도 단순한 숫자 이상의 의미를 가집니다. 사람이 일하는 방식도, 기업이 사람을 활용하는 방식도 '고정된 조직'에서 '필요한 전문성을 연결하는 조직'으로 이동하고 있다는 신호입니다. 플렉스웍은 기업이 필요한 순간, 필요한 전문성을 가진 Specialist와 협업할 수 있도록 연결합니다. 스페셜리스트 매칭 방법 알아보기
플렉스웍
업무 범위 한 줄 잘못 쓰면 벌어지는 일 (feat. 이것도 포함인 줄 알았어요)
“영업팀 교육도 당연히 포함된 줄 알았어요.” “저는 설정 진단과 개선안까지만 생각했습니다.” 프리랜서 프로젝트 업무 범위와 완료 기준은 어떻게 정해야 할까요? 할 일만 나열하지 말고 산출물·완료 기준·제외 항목·고객 의무를 함께 적어야 합니다. 견적과 일정이 맞아도 서로 다른 끝을 상상하면 프로젝트는 중간에 흔들립니다. 착수 전에 답해야 할 질문은 세 가지입니다. 고객에게 무엇이 남는가? 누가 어떤 증거로 완료를 확인하는가? 처음 합의에 없던 요청은 어떻게 결정할 것인가? 프리랜서 업무 범위는 무엇을 기준으로 정해야 하나요?업무 범위는 할 일 목록이 아니라 끝난 상태에 대한 합의입니다. 고객 문제, 제공 결과, 완료 기준, 제외 항목, 고객 의무를 적고 변경 절차를 운영 규칙으로 붙이세요. 고객이 문서를 읽고 포함 여부와 완료 여부를 스스로 확인할 수 있어야 합니다. “데이터를 분석한다”는 행동만으로는 분석 대상도 결과물도 알 수 없습니다. “최근 6개월 유입 데이터를 합의한 채널 기준으로 분류하고, 마케팅 책임자가 원본 수치와 분류 기준을 확인하면 진단 단계를 완료한다”라고 쓰면 대상·형식·검토자가 보입니다. 최근 6개월이라는 기간은 아래 합성 사례의 조건일 뿐, 모든 프로젝트에 적용하는 기준은 아닙니다. 범위 문서에는 고객의 책임도 들어갑니다. 자료와 접근 권한, 인터뷰 참석자, 승인권자 피드백이 없으면 전문가가 다음 작업을 시작할 수 없기 때문입니다. 고객 의무를 적는 목적은 책임을 떠넘기는 것이 아니라 작업이 가능한 조건을 함께 확인하는 데 있습니다. “마케팅 자동화 개선”은 왜 서로 다르게 해석됐나요?같은 업무명도 각자가 떠올리는 산출물이 다르면 범위가 달라집니다. 요청을 받은 뒤 바로 착수하지 말고 전문가의 해석과 고객의 기대를 항목별로 대조해야 합니다. 아래 사례에서 달라진 것은 성과가 아니라 확인 가능한 대화의 기준입니다. 아래는 이해를 돕기 위한 합성 사례입니다. 인물·회사·상황은 실제 사례가 아니며 특정 수익이나 성과를 보장하지 않습니다. B2B 마케팅 운영 경력 9년인 윤서진은 주 20시간, 8주 프로젝트에서 “마케팅 자동화 개선”을 요청받았습니다. 서진은 기존 설정을 진단하고 개선 우선순위를 정한 뒤 일부 설정을 바꾸는 일로 이해했습니다. 고객은 새 도구 도입과 영업팀 교육도 당연히 포함된다고 생각했습니다. 서진은 요청을 진단 보고서, 개선 우선순위안, 합의된 설정 변경으로 나눴습니다. 새 도구 도입은 별도 검토 항목, 영업팀 교육은 선택 항목으로 표시하고 승인권자와 피드백 기한은 고객 절차에 맞춰 정하도록 했습니다. 마지막으로 두 사람은 포함 항목, 제외 항목, 완료 증거를 한 줄씩 읽었습니다. 이 합의가 일정이나 사업 성과를 보장하는 것은 아니지만, 변경 여부를 판단할 출발점은 남깁니다. 모호한 업무명은 어떤 문장으로 바꿔야 하나요?동사보다 남는 결과와 확인 증거를 쓰세요. 좋은 범위 문장은 고객이 열어 볼 파일이나 기록, 검토할 사람, 확인 방법을 보여줍니다. 마케팅 자동화를 개선합니다: 기존 설정을 진단하고 우선순위안과 합의된 설정 변경 목록을 제공합니다. 확인 증거는 진단 보고서, 우선순위 승인, 변경 기록입니다. 데이터를 분석합니다: 최근 6개월 유입 데이터를 합의한 채널 기준으로 분류합니다. 확인 증거는 분류표와 원본 대조 기록입니다. 교육을 지원합니다: 영업팀 교육은 기본 범위에서 제외하고 선택 항목으로 별도 확인합니다. 확인 증거는 포함·제외 표와 변경 승인 기록입니다. 운영을 안정화합니다: 오류 유형과 대응 절차를 문서화하고 승인권자가 포함 항목을 확인합니다. 확인 증거는 오류 목록, 운영 절차서, 승인 기록입니다. “전반적으로”, “필요한 만큼”, “만족할 때까지” 같은 말은 종료 조건을 흐립니다. 상세 수준을 아직 정하지 못했다면 임의로 채우지 말고 결정할 사람과 결정 시점을 미확인 항목으로 남기세요. 완료 기준에는 무엇을 써야 하나요?완료 기준에는 대상, 형식이나 수준, 포함 항목, 승인권자, 확인 방법이 필요합니다. “완벽하게 끝낸다”가 아니라 양쪽이 같은 증거를 보고 완료라고 기록할 수 있는 문장이어야 합니다. [대상]을 [형식/수준]으로 제공하고, [승인권자]가 [기준]에 따라 확인하면 완료한다. 합성 사례에서는 “최근 6개월 유입 데이터를 채널별로 분류하고 개선 우선순위 5개를 제시한 뒤, 마케팅 책임자가 원본과 분류 기준을 확인하면 완료한다”라고 쓸 수 있습니다. 기간과 개수는 사례 조건이며 실제 프로젝트에서는 자료 범위와 고객의 승인 절차에 맞춰 합의해야 합니다. 제외 항목과 고객 의무는 어떻게 말해야 하나요?포함되지 않은 일과 고객이 제공해야 할 조건을 착수 전에 평이하게 말하세요. 기한은 특정 영업일을 보편 규칙으로 정하지 말고 긴급도, 활동 시간, 고객의 내부 절차에 맞춰 합의합니다. “이번 기본 범위에는 진단 보고서, 우선순위안, 합의된 설정 변경이 포함됩니다.” “새 도구 도입과 영업팀 교육은 현재 범위에 포함되지 않으며, 필요하면 영향을 검토한 뒤 선택 항목으로 확인하겠습니다.” “진행에는 기존 설정 접근 권한, 최근 6개월 데이터, 승인권자의 피드백이 필요합니다.” “자료나 승인이 늦어질 경우 일정 영향을 함께 확인한 뒤 계획을 갱신하겠습니다.” 1페이지 업무 범위 메모는 운영 논의용 참고 자료이며 완성된 계약서나 법률·세무 자문이 아닙니다. 비용, 기한, 변경과 계약 문구는 적용되는 계약과 당사자 상황에 따라 달라질 수 있으므로 최신 조건을 확인하고 필요하면 관련 전문가의 검토를 받으세요. 추가 요청은 수용하거나 거절하기 전에 무엇을 확인하나요?추가 요청은 기록한 뒤 목적과 기존 범위의 차이를 먼저 확인하세요. 일정·비용·품질에 미칠 영향을 검토하고 선택지를 제시한 다음, 양측이 승인한 내용만 문서와 계획에 반영합니다. 요청 기록 → 목적 확인 → 기존 범위와 차이 확인 → 일정·비용·품질 영향 검토 → 선택지 제시 → 양측 승인 → 문서 갱신 영향이 아직 확인되지 않았다면 숫자나 기한을 추정하지 말고 검토가 필요한 항목으로 표시하세요. 착수 전 어떤 항목을 체크해야 하나요?[ ] 고객 문제와 업무 목적이 한 문장인가 [ ] 산출물의 수량·형식·전달 시점이 보이는가 [ ] 완료 기준과 승인권자가 있는가 [ ] 제외 항목이 구체적인가 [ ] 고객 제공 자료·권한·참석·피드백이 적혀 있는가 [ ] 추가 요청의 기록·영향 검토·승인 방법이 있는가 [ ] AI 입력 금지 정보와 사람 검토 항목을 확인했는가 [ ] 양측이 같은 의미로 이해했는지 미팅에서 읽어 확인했는가 AI는 업무합의서 작성에서 어디까지 도울 수 있나요?AI는 메모 분류와 누락 질문 초안, 표 정리를 보조할 수 있습니다. 계약 의미, 실제 승인, 비용과 고객 의무를 정하는 일은 맡기면 안 됩니다. 사람이 원문과 계약, 공식 정책을 대조하고 외부 공유 여부를 최종 판단해야 합니다. AI가 보조할 수 있는 일: 미팅 메모 분류, 누락 질문 초안, 표 형식 정리 AI에게 맡기면 안 되는 일: 계약 의미 확정, 승인 추정, 고객 의무·비용 임의 생성 사람이 반드시 확인할 일: 원문·계약 대조, 수치·기한·승인자 확인, 외부 공유 판단 고객 자료를 AI 도구에 입력하기 전 고객사 보안정책, 계약, 사용 도구의 공식 약관·개인정보·데이터 사용 문서를 확인하세요. 정책과 도구는 바뀔 수 있으므로 필요하면 고객 보안 담당자에게 검토받고 확인일을 남기세요. 오늘 10분 안에 업무 범위 메모를 어떻게 완성하나요?모호한 업무명 하나를 고르고, 아래 일곱 칸을 채운 뒤 고객에게 같은 의미로 이해했는지 확인을 요청하세요. 작성하지 못한 칸은 숨기지 말고 착수 전 질문으로 표시합니다. 고객 문제: [ ] 제공 결과: [산출물·수량·형식·전달일] 완료 기준: [승인권자·포함 항목·확인 방법] 제외 항목: [ ] 고객 의무: [자료·권한·참석·피드백·기한] 변경 절차: [요청 기록→영향 검토→승인→갱신] AI 활용 조건: [허용 범위·입력 금지·사람 검토] 내 경험, 이제 업무 기회로 연결하세요오늘 정리한 업무 범위 메모에 전문 분야와 활동 가능 시간만 더하면, 프로젝트·시간제·커뮤니티 등 Flexwork의 다양한 기회에 바로 활용할 수 있는 전문가 프로필이 완성됩니다. 내 경험에서 해결할 수 있는 문제와 제공할 결과를 프로필에 정리해 보세요. Flexwork가 경험에 맞는 업무 기회와 기업 제안을 연결합니다. 전문가 프로필 등록하기
플렉스웍
프리랜서 고객 온보딩 실전: 첫 2주 프로젝트 체크리스트
“자료는 곧 드릴게요.” “이 방향으로 진행해 주세요.” 답은 왔는데 왜 다음 작업을 못 시작할까요? 프리랜서 고객 온보딩 첫 2주에는 자료·담당자·승인권자·채널·결정 기록을 정해 누가 무엇을 결정하는지 보여줘야 합니다. 빠른 답장과 잦은 연락이 프로젝트 진행을 보장하지는 않습니다. 첫 2주에 확인할 질문은 세 가지입니다. 필요한 원본은 누가 주는가? 방향과 완료는 누가 승인하는가? 질문과 결정은 어디에 기록하는가? 내가 해결할 수 있는 문제와 결과를 프로필에 보여주세요. 플렉스웍이 내 경험에 맞는 업무를 추천하고 기업이 업무를 제안합니다. 프로필 등록하기 첫 2주에 가장 먼저 고정할 것은 무엇인가요?정보, 사람, 채널, 기록의 네 축을 먼저 고정하세요. 각 항목마다 필요한 것, 소유자, 결정 시점, 완료 증거를 적으면 병목이 생긴 위치를 찾을 수 있습니다. 연락 횟수보다 의사결정 흐름이 보여야 다음 작업을 예측할 수 있습니다. 2편에서 만든 업무 범위 메모를 펼쳐 산출물마다 필요한 자료와 승인자를 연결합니다. 예를 들어 진단 보고서에는 원본 데이터와 접근 권한이 필요하고, 우선순위안에는 방향을 선택할 승인권자가 필요합니다. 자료가 왔다는 사실만 확인하지 말고 최신성, 필드, 누락 여부까지 검토해야 사용할 수 있는 입력이 됩니다. 사람은 실무 담당자, 자료 제공자, 승인권자, 보안 담당자로 구분합니다. 한 사람이 여러 역할을 맡을 수 있지만 이름만 적어서는 부족합니다. 어떤 결정을 내릴 수 있는지와 언제 참여해야 하는지를 고객과 확인하세요. 답장이 빠른데도 승인이 지연된 이유는 무엇인가요?실무 답변과 최종 승인은 다른 결정일 수 있습니다. 질문이 여러 채널에 흩어지고 승인권자가 대화에 없으면 메시지는 빠르게 오가도 작업은 멈춥니다. 아래 사례에서는 사람을 더 재촉하는 대신 결정 구조와 기록 위치를 바꿨습니다. 아래는 이해를 돕기 위한 합성 사례입니다. 인물·회사·상황은 실제 사례가 아니며 특정 수익이나 성과를 보장하지 않습니다. 요일과 기간도 이 사례의 운영 조건일 뿐 모든 프로젝트의 권장 표준이 아닙니다. 9년 차 B2B 마케터 윤서진은 주 20시간, 8주 프로젝트에서 실무 담당자 박민호와 수시로 메시지를 주고받았습니다. 박민호는 질문마다 빠르게 의견을 줬지만, 최종 승인권자 이수진은 대화에 없었습니다. 질문은 메신저, 이메일, 회의 메모에 나뉘어 같은 항목의 최신 답을 찾기도 어려웠습니다. 잘못된 접근은 박민호에게 “확정된 것으로 보고 진행하겠습니다”라고 답하는 것이었습니다. 실무 의견을 최종 승인으로 해석하면 나중에 방향이 바뀌어도 어떤 결정이 유효했는지 확인하기 어렵습니다. 서진은 관계자별 역할과 결정 범위를 한 장에 적고, 모든 질문을 결정 로그 한곳에 모았습니다. 사례에서는 화요일에 진행 상황을 공유하고 목요일에 결정이 필요한 항목을 요청했습니다. 각 행에는 질문, 권고안, 결정자, 합의 시점, 상태를 적었습니다. 고객은 자신이 확인할 항목과 시점을 볼 수 있게 됐고, 서진은 승인 전 작업과 승인 후 작업을 구분할 수 있었습니다. 실제 기간 단축이나 사업 성과를 뜻하지는 않습니다. 이 장면의 흐름은 '고객 문제: 승인권자와 최신 결정이 보이지 않음 → 전문가 행동: 역할표와 단일 결정 로그 작성 → 확인 가능한 결과물: 관계자·결정권 표와 승인 기록 → 완료 기준: 고객이 역할·채널·현재 결정을 확인'입니다. 각 프로젝트에서는 실제 조직 구조와 승인 절차에 맞춰 내용을 바꿔야 합니다. 빠른 소통과 예측 가능한 운영은 어떻게 다른가요?빠른 소통은 답변 속도를 보여주지만, 예측 가능한 운영은 다음 결정을 누가 어디에서 내릴지 보여줍니다. 고객이 확인할 증거를 남겨야 담당자가 바뀌거나 대화가 길어져도 같은 기준으로 이어갈 수 있습니다. 빠르지만 멈추는 운영: 실무 담당자에게 모든 질문 예측 가능한 운영: 질문별 담당자와 승인권자 구분 고객이 확인할 증거: 관계자·결정권 표 빠르지만 멈추는 운영: 메신저·메일·회의에 기록 분산 예측 가능한 운영: 질문·결정·담당자·기한을 한곳에 기록 고객이 확인할 증거: 결정 로그 빠르지만 멈추는 운영: “가능한 빨리” 답변 요청 예측 가능한 운영: 긴급도와 활동 시간에 맞춘 응답 기준 합의 고객이 확인할 증거: 소통 규칙 문서 빠르지만 멈추는 운영: 회의에서 구두 승인 예측 가능한 운영: 공식 승인 채널과 승인 문구 확인 고객이 확인할 증거: 승인 메일·합의 기록 빠르지만 멈추는 운영: 자료 수신만 확인 예측 가능한 운영: 최신성·필드·누락 여부까지 확인 고객이 확인할 증거: 자료 수신·검증 체크표 응답 기준은 일방적으로 통보하지 않습니다. 전문가의 활동 가능 시간, 고객의 내부 승인 절차, 업무 긴급도를 함께 보고 합의합니다. 긴급 이슈의 정의도 “급한 것”이 아니라 어떤 상태에서 어떤 수단을 쓰는지 적어야 합니다. 관계자와 승인권자는 어떻게 구분하나요?역할 이름보다 결정 범위를 적으세요. 실무 담당자는 일상 질문, 자료 제공자는 원본과 접근 권한, 승인권자는 방향과 완료, 보안 담당자는 데이터와 도구 사용 조건을 확인합니다. 조직마다 구조가 다르므로 실제 이름과 참여 시점을 고객에게 확인해야 합니다. 예를 들어 실무 담당자가 분류 기준 초안에 의견을 줄 수 있어도 최종 방향을 승인할 권한은 없을 수 있습니다. 반대로 승인권자가 모든 회의에 참석할 필요는 없지만, 선택이 필요한 시점과 검토 형식을 미리 알아야 합니다. 역할표에는 '이름 / 역할 / 결정 범위 / 필요한 시점 / 공식 기록 채널'을 한 행으로 적으세요. 보안 담당자는 AI 사용이나 녹취가 포함될 때 특히 필요합니다. 담당자를 찾지 못했다면 허용된 것으로 추정하지 말고 확인이 필요한 상태로 남깁니다. 고객에게 어떤 문장으로 자료와 결정을 요청하나요?요청에는 필요한 항목, 필요한 이유, 다음 작업에 미치는 영향, 확인할 사람을 넣으세요. 압박하거나 책임을 돌리기보다 고객이 어떤 결정을 해야 하는지 보이게 쓰는 편이 낫습니다. “진단을 시작하려면 '[자료/접근 권한]'이 필요합니다. '[합의 시점]'까지 제공 가능 여부와 자료 담당자를 확인해 주세요.” “이 항목은 실무 의견이 아니라 '[결정 내용]'의 승인이 필요합니다. 최종 승인권자와 기록할 채널을 알려주세요.” “현재 '[누락 자료/결정]'이 없어 '[다음 작업]'을 시작하기 어렵습니다. 제공 시점이 바뀌면 일정 영향을 함께 갱신하겠습니다.” “일상 질문은 '[채널]', 긴급 이슈는 '[수단]', 공식 승인은 '[기록 도구]'에서 확인하는 것으로 이해했습니다.” “오늘 회의에서 정한 내용은 '[결정]', 담당자는 '[이름]', 기한은 '[날짜]'입니다. 다르게 이해한 부분이 있으면 알려주세요.” 기한과 응답시간은 고객의 절차와 프로젝트 규모에 따라 달라집니다. 확인하지 않은 시간을 약속하거나 침묵을 승인으로 간주하지 마세요. 승인으로 인정할 문구와 채널을 당사자 간에 명시해야 합니다. 첫 2주 고객 온보딩은 어떤 순서로 진행하나요?시작 전에는 입력을 확인하고, 첫 며칠에는 결정 구조를 드러내며, 2주차에는 초기 결과와 위험을 공유하세요. 아래 시점은 합성 사례를 바탕으로 한 가이드이며 고객 절차와 프로젝트 규모에 맞춰 조정해야 합니다. 시점: 시작 전 전문가 행동: 목표·범위·일정 재확인 고객 요청: 계약·자료·접근 권한 완료 증거: 필수·누락 목록 시점: 1~2일 전문가 행동: 관계자·결정 구조 확인 고객 요청: 담당자·승인권자 참석 완료 증거: 역할·결정권 표 시점: 3~5일 전문가 행동: 현황 진단·질문 통합 고객 요청: 누락 자료·우선순위 답 완료 증거: 핵심 가정 승인 기록 시점: 2주차 전문가 행동: 초기 결과·위험 공유 고객 요청: 방향 선택·피드백 완료 증거: 다음 단계 승인 각 단계의 완료 증거가 없으면 다음 단계로 넘어갈 조건을 다시 확인합니다. 자료를 받았더라도 원본의 최신성과 필드가 맞지 않으면 “수신 완료, 검증 미완료”로 나눠 기록하세요. 킥오프 전에 무엇을 체크해야 하나요?아래 아홉 항목을 한 장에서 확인하세요. 빈칸은 추측하지 말고 담당자와 확인 시점을 적습니다. [ ] 목표·범위·제외 항목을 다시 읽었다 [ ] 필요한 자료·접근 권한·최신성 기준을 적었다 [ ] 실무 담당자·자료 제공자·승인권자·보안 담당자를 확인했다 [ ] 역할별 결정 범위와 참여 시점을 확인했다 [ ] 일상·긴급·공식 승인 채널을 구분했다 [ ] 양측 응답 기준을 활동 가능 시간과 조직 절차에 맞춰 합의했다 [ ] 정기 공유의 참석자·시점·형식을 정했다 [ ] 질문·결정·담당자·기한의 단일 기록 위치를 정했다 [ ] AI 입력·녹취·공유 가능 범위를 공식 정책으로 확인했다 AI 회의 요약은 언제 공유할 수 있나요?AI 회의 요약은 사람이 원문과 대조한 뒤에만 공유하세요. 참석자, 발언 맥락, 수치, 결정, 담당자, 기한을 확인하고, 실제로 말하지 않은 합의가 추가되지 않았는지 봐야 합니다. 승인권자를 AI가 추정하게 해서는 안 됩니다. AI가 보조할 수 있는 일: 회의 메모 요약 초안, 할 일 분류, 형식 정리 AI에게 맡기면 안 되는 일: 발언하지 않은 합의·승인·기한 생성 사람이 반드시 확인할 일: 참석자·발언 맥락·수치·결정·담당자·기한 원문 대조 AI가 보조할 수 있는 일: 중복 질문 묶기 AI에게 맡기면 안 되는 일: 승인권자 추정 사람이 반드시 확인할 일: 실제 결정권과 공식 승인 채널 확인 AI가 보조할 수 있는 일: 결정 로그 초안 AI에게 맡기면 안 되는 일: 허용 확인 전 녹취·민감정보 입력 사람이 반드시 확인할 일: 고객사 정책·계약·도구 공식 문서·외부 공유 범위 확인 회의 녹취나 메모를 AI 도구에 입력하기 전 고객사 보안정책과 계약, 도구의 공식 약관·개인정보·데이터 사용 문서를 확인하세요. 허용 범위와 보관 방식은 달라질 수 있으므로 필요하면 비식별화하고 고객 보안 담당자에게 검토받으세요. '확인 경로: 고객사 내부 정책·보안 담당자 / 사용 도구 공식 약관·개인정보·데이터 사용 문서', '확인일: YYYY-MM-DD'. 오늘 고객 온보딩 한 장을 어떻게 만드나요?현재 막힌 질문 하나를 고른 뒤 담당자, 승인권자, 채널, 기한을 아래에 적으세요. 고객에게 전달하기 전에 2편의 범위 메모와 일치하는지 확인합니다. 필요한 자료·권한: [ ] 실무 담당자/역할: [ ] 승인권자/결정 범위: [ ] 일상 질문 채널/확인 주기: [ ] 긴급 기준/연락 수단: [ ] 공식 승인 채널: [ ] 정기 공유(시점·참석자·형식): [ ] 결정 기록 위치: [ ] 현재 누락/영향/요청 기한: [ ] 작성 순서는 세 단계입니다. 지금 작업을 막는 자료나 결정 하나를 선택합니다. 담당자·승인권자·채널·기한과 다음 작업의 영향을 적습니다. 고객에게 같은 역할과 결정 흐름으로 이해했는지 확인을 요청하고 답을 기록합니다. 다음 편에서는 진척을 어떻게 보여주나요?운영 리듬이 생기면 고객이 진척을 확인할 수 있게 보여줘야 합니다. 다음 편에서는 활동 건수가 아니라 변화와 근거를 보고합니다. 함께 읽을 주제로 '프리랜서 주간 성과 보고서 작성법', '활동을 고객이 확인할 변화로 바꾸는 방법', '기준값과 현재 상태를 비교하는 보고 템플릿'을 제안합니다. 후속 콘텐츠로는 역할·결정권 표 예시와 의사결정 로그 운영법을 이어갈 수 있습니다. 오늘 만든 온보딩 한 장에 자신의 활동 가능 시간과 소통 가능한 시간대를 함께 적어 두세요. Flexwork에서 프로젝트·시간제·커뮤니티·전문가 기회를 준비할 때, 고객에게 운영 조건과 승인 요청 방식을 설명하는 자료로 활용할 수 있습니다. 내 경험을 업무 기회로 연결해보세요오늘 만든 다섯 문장에 전문 분야와 활동 가능 시간을 플렉스웍 프로필에 더해 두세요. 플렉스웍에서 프로젝트·시간제·커뮤니티·전문가 기회를 준비할 때, 직무명 대신 고객 문제·제공 결과·완료 기준·책임 한계를 설명하는 기본 자료로 활용할 수 있습니다. 프로필에 내가 해결할 수 있는 문제와 결과를 보여주면, 플렉스웍이 맞는 업무를 추천하고 기업과의 매칭을 돕습니다. 프로필 등록하기
플렉스웍
프리랜서가 되자마자 경력이 잘 통하지 않는 이유
“회사에서는 마케팅을 오래 하셨네요. 그런데 8주 뒤 저희가 확인할 수 있는 건 무엇인가요?” 이 질문에 업무 목록만 떠오른다면, 회사 경력을 '고객 문제 → 제공 결과 → 완료 기준 → 고객 제공 조건 → 책임 한계'로 바꿔 설명하세요. 첫 미팅 전에 다섯 항목을 문장으로 적으면 고객이 판단할 수 있는 제안이 됩니다. 첫 고객을 앞두면 보통 세 가지가 막힙니다. 내 경력 중 무엇을 꺼내야 할까? 어디까지 결과로 약속해야 할까? 고객과 무엇을 먼저 합의해야 할까? 답은 경력의 길이를 강조하는 데 있지 않습니다. 고객이 확인할 수 있는 결과와 그 결과를 만들 조건을 함께 보여주는 데 있습니다. 내가 해결할 수 있는 문제와 결과를 프로필에 보여주세요. 플렉스웍이 내 경험에 맞는 업무를 추천하고 기업이 업무를 제안합니다. 기업 제안 받을 프로필 만들기 프리랜서 첫 고객에게 무엇을 먼저 설명해야 하나요?고객 문제, 제공 결과, 완료 기준, 고객 제공 조건, 책임 한계를 먼저 설명하세요. 직무명이나 업무 목록은 그 다섯 가지를 뒷받침하는 근거로 사용하면 됩니다. 고객이 지금 겪는 문제를 확인합니다. 프로젝트가 끝난 뒤 남길 결과물을 적습니다. 누가 무엇을 검토하면 완료인지 정합니다. 고객이 제공할 자료·권한·결정 일정을 확인합니다. 전문가 혼자 통제할 수 없는 결과를 분리합니다. 회사에서는 조직이 우선순위와 권한, 검토 절차를 받쳐 줍니다. 외부 프로젝트에서는 이 구조가 자동으로 주어지지 않습니다. 같은 경력을 쓰더라도 전문가가 고객과 결과와 조건을 직접 합의해야 하는 이유입니다. “8주 뒤 무엇이 달라지나요?”에는 어떻게 답해야 하나요?활동이 아니라 고객이 직접 열어 보고 검토할 결과물로 답해야 합니다. 결과물의 포함 항목, 검토자, 필요한 고객 자료까지 말하면 답변이 제안으로 바뀝니다. 아래는 이해를 돕기 위한 합성 사례입니다. 인물·회사·상황은 실제 사례가 아니며 특정 수익이나 성과를 보장하지 않습니다. 9년 차 B2B 마케터 윤서진은 직원 45명인 B2B 서비스 기업과 주 20시간, 8주 프로젝트를 논의했습니다. 첫 미팅에서 서진은 “캠페인 점검, 데이터 정리, 회의 운영을 하겠습니다”라고 답했습니다. 고객은 다시 물었습니다. “그래서 8주 뒤 무엇을 확인할 수 있나요?” 서진은 답을 고쳤습니다. “현재 잠재고객 유입은 있지만 영업 전달 기준이 명확하지 않은 상태로 이해했습니다. 8주 동안 기존 데이터를 바탕으로 유입 분류표, 영업 전달 기준 문서, 주간 점검 템플릿을 만들겠습니다. 합의한 필드가 문서에 포함되고 승인권자의 검토가 끝나면 완료로 확인하겠습니다. 이를 위해 기존 데이터와 담당자 인터뷰 시간, 승인권자 피드백이 필요합니다. 최종 매출과 영업팀의 실행 속도는 제가 단독으로 통제할 수 없어 보장 범위에서 제외합니다.” 수정 뒤에 달라진 것은 성과가 아니라 대화의 기준입니다. 고객은 산출물, 완료 판단, 제공 자료, 제외 결과를 하나씩 확인할 수 있게 됐습니다. 이 네 가지를 합의하지 않은 채 “마케팅 성과를 높이겠다”고만 말하면 기대가 어긋나기 쉽습니다. 회사식 업무 설명과 고객식 결과 설명은 어떻게 다른가요?회사식 설명은 내가 한 활동을 보여주고, 고객식 설명은 프로젝트가 끝난 뒤 고객에게 무엇이 남는지 보여줍니다. 경력은 '직무명 → 문제 → 행동 → 증거' 순서로 풀어야 고객이 자신의 문제에 적용할 수 있는지 판단할 수 있습니다. 캠페인을 운영했습니다고객식 표현: 유입을 합의한 기준으로 분류하고 영업 전달 절차를 정리합니다.확인할 증거: 분류표, 전달 기준 문서 데이터를 정리합니다고객식 표현: 기존 데이터의 필드와 누락 기준을 정리해 검토 가능한 목록을 만듭니다.확인할 증거: 데이터 사전, 누락 목록 회의를 운영합니다고객식 표현: 주간 점검에서 결정할 항목·담당자·기한을 기록합니다.확인할 증거: 회의 템플릿, 결정 기록 마케팅 성과를 높입니다고객식 표현: 유입 분류 기준과 주간 점검 절차를 설계합니다.확인할 증거: 기준 문서, 점검 기록 마지막 두 문장은 비슷해 보이지만 책임 범위가 다릅니다. 매출과 같은 최종 성과는 고객의 실행, 시장 상황 등 여러 조건의 영향을 받습니다. 전문가는 자신이 통제할 수 있는 산출물과 절차를 제시하고, 그 밖의 결과는 고객과 조건을 확인해야 합니다. 첫 고객 제안 문장은 어떤 순서로 만들면 되나요?'문제 → 결과 → 완료 → 고객 조건 → 책임 한계' 순서로 한 문장씩 쓰세요. 각 문장은 고객이 질문하거나 확인할 수 있을 만큼 구체적이어야 합니다. 고객 문제: “성과가 낮다”보다 “유입은 있지만 영업 전달 기준이 없다”처럼 현재 상태를 씁니다. 제공 결과: “분석하겠습니다”보다 “유입 분류표와 전달 기준 문서를 만들겠습니다”라고 씁니다. 완료 기준: 문서 형식, 포함 항목, 검토자와 완료 시점을 적습니다. 고객 제공 조건: 데이터, 접근 권한, 인터뷰 시간, 승인권자 피드백을 적습니다. 책임 한계: 매출이나 고객사 실행 속도처럼 혼자 통제할 수 없는 결과를 분리합니다. 고객에게는 다음 문장을 그대로 바꿔 말할 수 있습니다. “현재 `[고객 문제]' 상태로 이해했습니다. 사실과 우선순위가 맞는지 먼저 확인하고 싶습니다.” “저는 `[제공 결과]`를 만들고, `[포함 항목·검토자]`가 확인되면 완료로 보겠습니다.” “진행에는 고객의 `[자료·권한·결정]`이 필요하며, `[통제 불가 결과]`는 단독으로 보장하지 않습니다.” “성과를 높여드립니다”, “매출을 보장합니다”, “AI로 정확하게 해결합니다”처럼 조건 없이 단정하지 마세요. 책임 한계를 적는 것은 책임을 피하는 일이 아닙니다. 제공 결과와 고객 조건을 분리해 서로의 판단 기준을 맞추는 일입니다. 실제 계약상 책임과 조건은 당사자 간 합의 및 필요한 공식 검토를 거쳐야 합니다. 첫 미팅 전에 무엇을 확인해야 하나요?아래 일곱 항목이 모두 문장으로 적혀 있으면 첫 제안의 뼈대가 갖춰집니다. 비어 있는 항목은 추측해서 채우지 말고 고객에게 확인할 질문으로 남기세요. [ ] 고객 문제를 한 문장으로 썼다. [ ] 활동 목록이 아니라 남는 결과물을 썼다. [ ] 완료 기준과 검토·승인 주체를 썼다. [ ] 고객이 제공할 자료·권한·결정 일정을 썼다. [ ] 내가 통제할 수 없는 결과를 분리했다. [ ] AI 사용 범위와 사람의 검증 책임을 구분했다. [ ] 합의되지 않은 추가 요청을 어떻게 다룰지 질문으로 남겼다. 마지막 항목은 일을 시작한 뒤의 범위 확장을 막기 위한 질문입니다. 추가 요청의 처리 방식은 다음 편에서 다룰 계약범위, 완료조건, 제외항목과 함께 문서로 확인해야 합니다. AI에는 무엇을 맡기고 무엇을 맡기면 안 되나요?AI에는 분류와 초안, 형식 정리만 보조하게 하세요. 인터뷰 메모 정리 AI가 보조할 수 있는 일: 인터뷰 메 모 분류 초안 AI에 맡기면 안 되는 결정: 고객 정보의 입력·외부 공유 가능 여부 사람이 검토할 일: 원문과 분류 결과 대조 보고서 초안 작성 AI가 보조할 수 있는 일: 보고서 구조와 문장 초안 AI에 맡기면 안 되는 결정: 수치·성과의 사실 판정 사람이 검토할 일: 수치, 맥락, 누락, 표현 검증 체크리스트 정리 AI가 보조할 수 있는 일: 체크리스트 형식 정리 AI에 맡기면 안 되는 결정: 보안정책·약관 준수 여부의 단독 판단 사람이 검토할 일: 고객사 정책과 승인 절차 확인 반복 문서 요약 AI가 보조할 수 있는 일: 반복 문서 요약 AI에 맡기면 안 되는 결정: 결과물의 최종 승인 사람이 검토할 일: 원문 대비 오류와 빠진 내용 확인 고객 자료를 AI 도구에 입력하기 전 고객사 보안정책과 사용 도구의 공식 약관, 개인정보·데이터 사용 문서를 확인하세요. 민감정보 입력 가능 여부와 보관 방식은 도구와 시점에 따라 달라질 수 있습니다. 필요하면 고객사 보안 담당자에게 확인하고, AI 결과는 원문과 대조한 뒤 사람이 승인해야 합니다. 확인 경로: 고객사 내부 정책·보안 담당자 사용 도구 공식 약관·개인정보·데이터 사용 문서 확인일: YYYY-MM-DD 오늘 10분 안에 무엇을 완성하면 되나요?다섯 칸을 채운 뒤 소리 내어 읽고, 첫 고객 미팅 자료에 붙이세요. 고객이 결과물과 완료 여부를 확인할 수 없다면 표현을 한 번 더 구체화합니다. 고객 문제: 현재 [ ] 상태입니다. 제공 결과: 저는 [ ]을/를 만들겠습니다. 완료 기준: [ ]이면 완료로 확인합니다. 고객 제공 조건: 진행에는 [ ]이/가 필요합니다. 책임 한계: [ ]은/는 제가 단독으로 보장하지 않습니다. 작성 순서는 세 단계입니다. 최근 회사 업무 하나를 골라 `문제 → 행동 → 증거`로 적습니다. 위 다섯 칸에 옮기고, 활동 표현을 고객이 확인할 결과물로 바꿉니다. 비어 있는 조건을 첫 미팅 질문으로 표시한 뒤 문서를 저장합니다. 완성 예시는 이렇습니다. 고객 문제: 현재 유입은 있지만 영업 전달 기준이 명확하지 않은 상태입니다. 제공 결과: 저는 유입 분류표와 영업 전달 기준 문서, 주간 점검 템플릿을 만들겠습니다. 완료 기준: 합의한 필드가 포함되고 승인권자의 검토가 끝나면 완료로 확인합니다. 고객 제공 조건: 진행에는 기존 데이터, 담당자 인터뷰 시간, 승인권자 피드백이 필요합니다. 책임 한계: 최종 매출과 영업팀의 실행 속도는 제가 단독으로 보장하지 않습니다. 첫 고객 제안에서 자주 묻는 질문은 무엇인가요?경력의 길이보다 고객이 확인할 수 있는 결과와 조건이 중요합니다. 아래 질문은 첫 미팅 전에 답을 준비해 두면 좋습니다. 경력이 길면 고객이 알아서 가치를 이해하지 않나요?고객은 경력만으로 자신의 문제가 어떻게 달라질지 알기 어렵습니다. 경력을 고객 문제, 내가 할 행동, 남길 증거로 번역해 보여주세요. 제공 결과와 완료 기준은 무엇이 다른가요?제공 결과는 프로젝트 뒤에 남는 산출물이고, 완료 기준은 그 산출물을 누가 어떤 조건으로 확인할지 정한 기준입니다. 매출처럼 중요한 결과를 책임 범위에서 빼도 되나요?중요한 결과라도 전문가 혼자 통제할 수 없다면 단독 보장하지 않는다고 밝히고, 대신 자신이 제공할 산출물과 조건을 구체적으로 합의해야 합니다. 고객 자료를 AI에 넣어도 되나요?일괄적으로 허용하거나 금지할 수 없습니다. 입력 전에 고객사 내부 정책·보안 담당자와 사용 도구의 공식 약관·개인정보·데이터 사용 문서를 확인하고 확인일을 남기세요. 내 경험을 업무 기회로 연결해보세요오늘 만든 다섯 문장에 전문 분야와 활동 가능 시간을 플렉스웍 프로필에 더해 두세요. 플렉스웍에서 프로젝트·시간제·커뮤니티·전문가 기회를 준비할 때, 직무명 대신 고객 문제·제공 결과·완료 기준·책임 한계를 설명하는 기본 자료로 활용할 수 있습니다. 프로필에 내가 해결할 수 있는 문제와 결과를 보여주면, 플렉스웍이 맞는 업무를 추천하고 기업과의 매칭을 돕습니다. 전문가 프로필 등록하기
플렉스웍
AI 시대, 채용의 단위가 바뀝니다
더 많은 콘텐츠가 플렉스웍 뉴스레터로 배달됩니다. AI와 함께 일하는 조직들의 실제 워크플로우, HR·인재 이야기를 매주 구독해보세요. 플렉스웍 뉴스레터 구독하기 사람을 채용하기 전에, 업무부터 다시 나누기Flexwork x 기고만장 웨비나 2부 · 임태은 베러웍스(FlexWork) 대표 발표 정리 “AI가 일을 더 작은 단위로 쪼갤 수 있게 만들었다면, 사람을 활용하는 방식도 달라져야 하지 않을까요?” AI가 조직에 들어오면서 가장 눈에 띄는 변화는 업무 속도입니다. 리서치하고, 정리하고, 초안을 만들고, 반복적인 실행 업무를 처리하는 데 필요한 시간이 크게 줄어들고 있습니다. 하지만 임태은 대표가 이번 세션에서 이야기한 변화는 단순히 “AI를 쓰면 한 사람이 더 많은 일을 할 수 있다”는 데 그치지 않습니다. 업무 자체를 더 작은 단위로 나눌 수 있게 되면서, 그 업무를 수행할 사람을 찾는 방식도 달라지고 있다는 것입니다. 기존에는 새로운 문제가 생기면 먼저 사람을 채용했습니다. 하지만 앞으로는 먼저 무슨 업무를 해결해야 하는지 정의하고, AI가 할 수 있는 일과 내부 구성원이 해야 하는 일, 외부 전문가의 경험이 필요한 일을 구분한 뒤 필요한 역량을 연결하는 방식이 중요해지고 있습니다. 핵심 메시지AI 시대의 인재 전략은 ‘어떤 사람을 채용할 것인가’에서 ‘어떤 업무를 누구에게 맡길 것인가’로 이동하고 있습니다. 하나의 직무 안에는 사실 서로 다른 성격의 업무가 섞여 있습니다. 자료를 찾는 일, 정리하는 일, 결과물을 만드는 일, 이해관계자와 조율하는 일, 전문적인 판단을 내리는 일까지 모두 한 사람의 역할로 묶여 있었습니다. 그런데 AI가 일부 실행 업무를 맡기 시작하면 이 묶음을 다시 나눌 수 있습니다. AI가 맡을 수 있는 일은 AI에게 넘기고, 조직 내부에서 반드시 책임져야 하는 일은 내부 구성원이 맡고, 특정 경험이나 전문성이 필요한 순간에는 외부 전문가가 들어올 수도 있습니다. 한 사람을 채용해 모든 업무를 맡기는 방식에서, 업무마다 가장 적합한 자원을 조합하는 방식으로 조직 운영의 단위가 바뀌고 있는 것입니다. 이미 글로벌 기업은 ‘사내 긱워커’를 활용하고 있습니다이 변화는 아직 먼 미래의 이야기가 아닙니다. 이미 글로벌 기업에서는 정규직으로 채용한 인재조차 하나의 고정된 직무에만 묶어두지 않고, 필요한 프로젝트와 업무 단위로 다시 연결하고 있습니다. 대표적인 사례가 글로벌 에너지 관리 기업 Schneider Electric(슈나이더 일렉트릭)입니다. 슈나이더 일렉트릭은 직원들이 조직 안에서 새로운 기회를 더 쉽게 찾을 수 있도록 Open Talent Market이라는 내부 인재 마켓플레이스를 만들었습니다. 직원이 자신의 프로필과 스킬, 경험, 앞으로 쌓고 싶은 역량을 등록하면 AI가 이를 바탕으로 조직 안의 다양한 기회를 추천합니다. 여기서 연결되는 것은 단순히 다른 정규직 포지션만이 아닙니다. 다른 조직의 풀타임 역할 단기간 참여하는 프로젝트와 Gig 업무 기존 직무 밖에서 경험을 쌓는 Stretch Assignment 멘토 또는 멘티로 참여하는 기회 까지 하나의 플랫폼 안에서 연결됩니다. 예를 들어 베트남 법인에서 근무하던 한 인턴은 본래 담당 업무와 별개로 Open Talent Market을 통해 HR Analytics, 고객 설문 분석, 소프트웨어 개발 프로젝트 등에 참여했습니다. 인도, 싱가포르, 호주 등 다른 국가의 구성원들과 프로젝트 팀을 만들어 기존 소속이나 직무를 넘어 실제 업무를 함께 수행한 사례도 소개됐습니다. 즉 ‘이 사람은 어느 부서 소속인가’보다 ‘이 사람이 어떤 스킬을 가지고 있고, 지금 어떤 업무에 기여할 수 있는가’를 기준으로 조직 안의 인재를 다시 연결한 것입니다. 슈나이더 일렉트릭이 이런 시스템을 만든 배경에는 기존 인재 운영 방식에 대한 문제의식도 있었습니다. 당시 내부 분석에서는 회사를 떠나는 직원 상당수가 조직 안에서 앞으로 어떤 성장 기회가 있는지 충분히 보이지 않는다고 느끼고 있었습니다. 이에 회사는 새로운 사람을 외부에서 찾는 것뿐 아니라, 이미 조직 안에 있는 인재와 역량을 필요한 업무에 더 빠르게 연결하는 방식을 만들기 시작했습니다. Open Talent Market은 이후 내부 이동뿐 아니라 프로젝트, Gig, 멘토링을 연결하는 조직 내 일종의 ‘긱 이코노미’로 확장됐습니다. 사람을 하나의 직무에 고정하는 대신, 조직 안에서도 필요한 업무와 프로젝트에 따라 인재를 유연하게 연결하는 것입니다. 이 사례에서 중요한 것은 단순히 사내 프로젝트 게시판을 만들었다는 점이 아닙니다. ‘한 사람 = 하나의 직무’라는 전통적인 조직 운영 단위를 깨고, 사람의 스킬과 조직의 업무를 더 작은 단위에서 매칭하기 시작했다는 점입니다. 그리고 AI가 실행 업무를 더 작은 단위로 나누기 시작한 지금, 이러한 방식은 조직 내부를 넘어 외부 인재를 활용하는 방식으로도 이어지고 있습니다. 업무가 작아지면 채용 단위도 작아집니다슈나이더 일렉트릭이 조직 내부의 사람을 프로젝트와 Gig 단위로 다시 연결했다면, 같은 변화는 조직 밖의 인재를 활용하는 방식에서도 나타나고 있습니다. 기존 조직에서는 사람과 업무가 강하게 묶여 있었습니다. 새로운 문제가 생기면 해당 직무의 사람을 채용하고, 그 사람이 관련된 업무 전체를 담당하는 방식이 일반적이었습니다. 하지만 AI를 활용하면 기존 직무 안의 업무를 더 세밀하게 나눌 수 있습니다. 예를 들어 하나의 프로젝트를 진행한다고 할 때, 자료를 수집하는 일 정보를 구조화하는 일 초안을 만드는 일 반복적인 운영 업무 특정 도메인의 경험이 필요한 판단 최종 의사결정과 책임 을 하나의 역할로 묶어둘 필요가 줄어듭니다. 일부 실행은 AI가 담당하고, 내부 담당자는 맥락과 의사결정을 담당하며, 조직 안에 없는 전문성이 필요한 부분에만 외부 전문가가 참여할 수 있습니다. 업무의 단위가 작아질수록 사람을 활용하는 단위도 ‘한 명의 풀타임 인력’보다 작아질 수 있는 것입니다. 정규직 채용만으로 해결하기 어려운 이유정규직 채용은 여전히 조직에 중요한 방식입니다. 특히 장기적으로 조직의 핵심 역량을 쌓아야 하는 역할이라면 내부 인력이 필요합니다. 다만 모든 문제를 정규직 채용으로 해결하려 하면 몇 가지 현실적인 어려움이 생깁니다. 속도조직에서 어떤 문제가 생긴 시점과 새로운 사람이 실제로 일을 시작하는 시점 사이에는 차이가 있습니다. 공고를 만들고, 후보자를 찾고, 인터뷰하고, 입사 시점을 조율해야 합니다. 반면 현업에서 해결해야 하는 문제는 이미 발생한 상태입니다. 전문성필요한 전문성이 하나의 직무에 깔끔하게 들어맞지 않는 경우도 많습니다. 특정 프로젝트에서는 AI 자동화 경험이 필요하고, 다른 단계에서는 도메인 전문가의 판단이 필요할 수 있습니다. 이 모든 역량을 한 사람이 동시에 가지고 있기를 기대하면 인재를 찾는 난이도가 크게 높아집니다. 활용 기간전문가의 역량이 필요하더라도 반드시 장기간, 주 5일 필요한 것은 아닙니다. 특정 프로젝트를 시작할 때 몇 주간의 경험이 필요할 수도 있고, 매주 몇 시간 정도의 리뷰와 의사결정만 필요할 수도 있습니다. 필요한 전문성과 필요한 시간이 서로 다르다면, 사람을 활용하는 방식도 하나일 필요가 없습니다. Fractional Talent: 필요한 전문성을 필요한 만큼 활용하기이러한 변화와 함께 발표에서는 Fractional Talent라는 인재 활용 방식이 소개됐습니다. Fractional Talent는 특정 분야의 전문가가 하나의 조직에 풀타임으로 소속되지 않고, 여러 조직에 자신의 전문성을 일정 부분씩 제공하는 방식입니다. 예를 들어 한 기업에 주 5일 근무하는 CMO 대신 여러 기업의 마케팅 전략을 일정 시간씩 맡는 Fractional CMO, 제품이나 기술 조직의 중요한 의사결정에 일정 시간 참여하는 Fractional CTO 같은 형태입니다. 중요한 것은 단순히 근무 시간이 짧다는 점이 아닙니다. 조직이 필요한 전문성을 ‘직무 전체’가 아니라 ‘필요한 역할과 시간’ 단위로 활용한다는 점입니다. AI로 실행 업무를 처리할 수 있는 범위가 넓어질수록 이러한 방식은 더욱 현실적인 선택지가 됩니다. 전문가가 반드시 모든 실행을 직접 할 필요 없이, 중요한 방향을 잡고 판단 기준을 만들고 내부 구성원과 AI가 움직일 수 있는 구조를 만드는 데 집중할 수 있기 때문입니다. Nano Hiring: 사람보다 업무에서 출발하기발표에서는 사람을 활용하는 단위가 더 작아지는 흐름을 Nano Hiring이라는 개념으로도 설명했습니다. 기존 채용에서는 먼저 한 명의 사람을 채용하고 그 사람에게 업무를 배분합니다. Nano Hiring에서는 반대로 접근합니다. 먼저 해결해야 할 업무를 구체적으로 나누고, 해당 업무를 처리하는 데 어떤 역량이 필요한지를 정한 뒤 사람을 연결합니다. 즉, 사람을 채용한다 → 역할을 부여한다 → 업무를 맡긴다 는 흐름에서 업무를 정의한다 → 필요한 역량을 찾는다 → AI·내부 인력·외부 전문가를 배치한다 는 흐름으로 바뀌는 것입니다. 이 차이는 작아 보이지만 조직 설계에는 큰 영향을 줍니다. 이제 사람의 직함이나 소속보다 실제로 어떤 문제를 해결할 수 있는가가 더 중요한 기준이 됩니다. AI 전환이 어려운 이유는 ‘툴’보다 ‘업무를 쪼개는 일’에 있습니다세션 후 Q&A에서 임태은 대표는 AI 전환 과정에서 반복적으로 나타나는 문제도 짚었습니다. 조직에서는 흔히 “AI를 도입해야 한다”고 말하지만, 정작 현재 업무가 어떻게 돌아가고 있는지 구조화되어 있지 않은 경우가 많습니다. 일이 개인의 경험과 암묵지에 의존하고 있고, 누가 어떤 판단을 해서 다음 단계로 넘기는지 명확하지 않다면 AI를 적용하기도 어렵습니다. 발표에서는 이를 두고 DX도 제대로 되어 있지 않은데 AX부터 하기 어렵다는 취지의 이야기도 나왔습니다. 문서화되지 않은 업무를 AI에게 맡기려면 결국 사람이 알고 있는 암묵적인 기준까지 먼저 꺼내야 하기 때문입니다. 그래서 AI 전환의 시작은 새로운 AI 도구를 설치하는 것이 아니라, 현재 업무를 실제 수행 단위로 쪼개는 것 에 가까울 수 있습니다. 외부 전문가는 조직이 처음 길을 찾을 때 특히 중요합니다그런데 업무를 직접 나누는 것 자체가 쉽지 않은 조직도 많습니다. 내부에서는 지금까지 해오던 방식이 너무 익숙해 어떤 부분을 AI로 바꿀 수 있는지 판단하기 어렵기 때문입니다. 임태은 대표는 이런 상황에서 이미 비슷한 전환을 경험해본 외부 전문가가 어드바이저로 참여하는 방식을 이야기했습니다. 예를 들어 이미 AI를 활용한 조직 운영을 경험한 사람이 들어와 현재 업무를 함께 살펴보고, 어떤 업무부터 나눌 것인지 AI를 어디까지 활용할 수 있는지 내부 담당자가 계속 가져가야 할 영역은 무엇인지 어떤 영역에서 외부 전문성이 필요한지 어떤 팀부터 시작해야 효과가 클지 를 함께 정리하는 것입니다. 외부 전문가의 역할은 단순히 부족한 일손을 대신하는 데 있지 않습니다. 이미 한 번 겪어본 시행착오와 판단 기준을 조직 안으로 가져오는 데 더 큰 가치가 있을 수 있습니다. 전사 도입보다 먼저 ‘챔피언 부서’를 만드는 이유그렇다면 AI 전환은 모든 부서에서 동시에 시작해야 할까요? 발표와 이어진 Q&A에서는 오히려 성과가 빠르게 나올 수 있는 한 팀을 먼저 만드는 방식이 중요하게 언급됐습니다. 업무를 나눠보고 AI 적용 가능성이 높은 영역을 찾은 뒤, 먼저 하나의 부서에서 눈에 보이는 성과를 만드는 것입니다. 이를 일종의 챔피언 부서로 볼 수 있습니다. 한 팀이 기존보다 훨씬 빠르고 효율적으로 일하기 시작하면 다른 구성원들도 변화를 훨씬 구체적으로 받아들입니다. 막연하게 “앞으로 AI를 써야 한다”고 교육하는 것보다, “옆 팀은 저렇게 일해서 실제로 성과가 나고 있다” 는 것을 보여주는 것이 조직의 행동을 움직이기 쉽습니다. 이후 사례를 공유하고 조직 내에서 수요가 생기기 시작하면, 개별적인 지원과 교육을 확대하고 마지막 단계에서 전사 표준화로 이어갈 수 있습니다. 결국 마지막에는 조직문화가 남습니다하지만 업무 구조와 도구만 바꾼다고 새로운 방식이 정착되는 것은 아닙니다. 임태은 대표가 Q&A 후반부에서 특히 강조한 것은 조직문화였습니다. 외부 인재를 유연하게 활용하려 해도 기존 구성원이 이를 받아들이지 못하면 실행되지 않습니다. 업무 단위를 나누고 새로운 협업 구조를 적용하려 해도 리더와 구성원이 동의하지 않으면 움직이기 어렵습니다. 발표에서는 Schneider Electric이 사내 긱 플랫폼을 만들어 글로벌 조직의 인재를 프로젝트와 연결한 사례도 언급됐습니다. 이 정도 규모의 변화는 플랫폼 하나를 만드는 것만으로 일어나지 않습니다. 국가와 조직마다 서로 다른 반대와 이해관계를 조율하면서 새로운 인재 운영 방식을 실제 문화로 정착시키는 과정이 필요합니다. 새로운 인재 전략은 시스템을 하나 도입하는 프로젝트가 아니라, 조직이 사람과 일을 바라보는 문화를 바꾸는 일입니다. 그래서 AI 시대에 HR의 역할은 더 중요해집니다AI가 많은 실행 업무를 처리하면 HR의 역할이 줄어들 것이라고 생각할 수 있습니다. 하지만 발표에서 이어진 논의는 오히려 반대 방향을 가리킵니다. 조직이 일하는 방식을 더 유연하게 설계하려면 누군가는 어떤 업무를 AI가 맡을 수 있는지 어떤 역할을 내부에 남겨야 하는지 외부 전문가를 어디에 투입해야 하는지 새로운 협업 방식을 구성원이 받아들일 수 있는지 한 팀의 성공을 어떻게 조직 전체의 방식으로 확장할지 를 설계해야 합니다. 이 문제는 단순한 툴 선택보다 사람과 조직에 더 가까운 문제입니다. AI 시대의 HR은 필요한 사람을 채용하는 것에서 나아가, 필요한 역량을 조직 안팎에서 찾아 가장 적절한 위치에 배치하는 역할로 확장될 수 있습니다. 세 가지 시사점이번 발표와 Q&A의 내용을 세 가지로 정리할 수 있습니다. 1) 업무: 직무보다 먼저 일을 나눠봐야 합니다. AI가 기존 직무 안의 실행 업무를 일부 맡으면서, 하나의 사람에게 묶여 있던 일을 다시 나눌 수 있게 됐습니다. 2) 인재: 모든 전문성을 정규직 채용으로 확보할 필요는 없습니다. Fractional Talent와 Nano Hiring처럼 필요한 전문성을 업무와 시간 단위로 활용하는 방식이 새로운 선택지가 되고 있습니다. 3) 조직: AI 전환의 마지막 조건은 문화입니다. 먼저 작은 성공 사례를 만들고, 구성원이 필요성을 느끼게 하고, 새로운 방식의 협업을 조직이 받아들일 수 있어야 변화가 확산됩니다. 결국 AI 시대의 질문은 “몇 명을 더 채용할 것인가”가 아니라, “이 업무를 가장 잘 해결할 조합은 무엇인가”로 바뀌고 있습니다. AI, 내부 구성원, 외부 전문가. 이 세 가지를 어떤 업무에 어떻게 배치할 것인지 설계하는 능력이 앞으로 조직의 실행 속도와 경쟁력을 가르는 중요한 조건이 될 수 있습니다. 본 정리본은 Flexwork x 기고만장 웨비나 2부, 임태은 베러웍스(FlexWork) 대표 발표 및 세션 Q&A 내용을 바탕으로 작성되었습니다.
플렉스웍
글로벌 조직은 AI와 어떻게 일하고 있는가
더 많은 콘텐츠가 플렉스웍 뉴스레터로 배달됩니다. AI와 함께 일하는 조직들의 실제 워크플로우, HR·인재 이야기를 매주 구독해보세요. 플렉스웍 뉴스레터 구독하기 툴 도입이 아닌, 워크플로우 자체의 재설계Flexwork x 기고만장 웨비나 1부 · 황소흠 Product Designer 발표 정리 “AI 도구는 도입했는데, 왜 일하는 방식은 그대로일까요?” 웨비나 당시 황소흠님이 던진 이 질문에서 이야기가 출발합니다. 핵심 메시지이번 세션의 출발점은 명확합니다. AI 도구를 도입하는 것과, AI를 중심으로 업무 프로세스를 다시 설계하는 것은 전혀 다른 일이라는 것입니다. 많은 조직이 ChatGPT, Gemini, Copilot 같은 도구를 팀에 배포하는 데서 멈춥니다. 하지만 실제로 조직의 생산성과 경쟁력을 바꾸는 건 그다음 단계, 즉 “이 도구가 있다는 전제 하에 우리 업무 프로세스를 어떻게 다시 짤 것인가”라는 질문입니다. 발표는 이 메시지를 하나의 사례 기업을 통해 10개월간의 타임라인으로 풀어냅니다. 사례: 의료기기 인증 스타트업, 영국 메드테크 기업발표에 등장하는 회사는 의료기기 AI 인증 솔루션을 만드는 스타트업입니다. 병원, 의료기기 제조사를 대상으로 규제 인증 절차를 빠르게 통과할 수 있도록 돕는 서비스를 제공하며, 고객사 사례로 Flok Health, Lucida Medical, Floy 등이 소개됩니다. 규제 문서 검토, 인증 일정 관리처럼 원래 사람이 수작업으로 하던 업무를 AI로 구조화하는 것 자체가 이 회사의 사업이기도 합니다. 다만 이 발표에서 정작 흥미로운 지점은 이 회사가 만드는 제품이 아니라, 이 회사 내부의 일하는 방식이었습니다. 이 회사의 프로덕트 팀, 엔지니어링·디자인·프로덕트가 AI 도입 전후로 어떻게 달라졌는지가 발표의 핵심 사례입니다. Before아이디어에서 기능 출시까지, 엔지니어링·디자인·프로덕트가 순차적으로 일하는 구조였습니다. 한 직군이 자기 몫을 끝내야 다음 직군에 바통을 넘기는 방식이었고, 세 직군의 작업 구간이 시간 축 위에서 서로 겹치지 않았습니다. 그만큼 어느 한 단계가 지연되면 전체 리드타임이 그대로 늘어나는 구조였습니다. After같은 세 직군이 병렬적으로, 작업 구간을 서로 겹쳐가며 일하는 구조로 바뀌었습니다. 기능 출시까지 걸리는 시간이 눈에 띄게 단축된 것으로 소개됩니다. 핵심은 인원을 늘린 게 아니라, 순서대로 넘기던 협업 구조 자체를 동시에 진행하는 방식으로 바꿨다는 점입니다. AI를 활용해 각 직군이 다른 직군의 영역까지 일부 커버할 수 있게 되면서, “순서대로 넘기는” 협업이 아니라 “동시에 진행하는” 협업 구조 자체가 바뀌었습니다. 10개월의 도입 타임라인발표는 이 변화를 하나의 이벤트가 아니라 세 단계로 나누어 설명합니다. 2025년 10월 · 도입 시작디자인·프로덕트·의료 심사원·기술 운영팀이 각자 ChatGPT, Gemini, Copilot 같은 범용 AI 도구를 개별적으로 실험했습니다. 2026년 1월 · 과도기직군별로 구체적인 활용법이 자리 잡기 시작하지만, 팀마다 도구 활용 수준의 격차가 뚜렷하게 드러나는 시기였습니다. 2026년 8월 · 안정기범용 도구 활용을 넘어, 팀 고유의 워크플로우와 표준 프로세스로 정착했습니다. 이 타임라인이 시사하는 바는, AI 도입이 한 번의 의사결정이 아니라 최소 6개월에서 10개월가량의 조직적 학습 과정이라는 점입니다. “도입 시작” 시점과 “안정기” 시점의 활용 수준 차이가 크기 때문에, 단기간에 성과를 판단하기보다 단계별로 다른 목표를 설정하는 접근이 필요합니다. 직군별로 다르게 나타난 변화발표는 도입 시작 단계에서 디자인, 프로덕트, 의료 심사원, 기술 운영팀 네 그룹이 각각 다른 방식으로 AI를 실험했다고 설명합니다. 이 중 구체적 사례가 소개된 두 그룹은 다음과 같습니다. 디자인 팀: 산출물 자체가 바뀐 경우디자인 팀은 Figma 기반의 전통적 디자인 워크플로우에서, AI 기반 코드 생성 도구로 넘어갔습니다. Before 단계에서는 화면 단위로 여러 개의 디자인 파일을 만들어 관리했습니다. 디자이너가 화면을 설계해 개발자에게 전달하면, 개발자가 그 설계를 다시 코드로 옮기는 구조였습니다. After 단계에서는 이 방식이 재사용 가능한 UI 컴포넌트 라이브러리로 바뀝니다. 버튼, 인풋, 셀렉트 같은 요소들을 디자이너가 곧바로 “실제 작동하는 코드”로 만들고, “View code” 버튼을 통해 개발팀이 바로 재사용할 수 있는 구조입니다. 즉 디자이너와 개발자 사이에 있던 “전달”이라는 단계 자체가 사라지고, 디자이너가 설계와 동시에 검증까지 하는 쪽으로 역할이 확장된 사례입니다. 기술 운영팀: 반복 업무의 자동화기술 운영팀은 개발 환경 구축, 코드 리뷰, PR(Pull Request) 관리 같은 반복적이고 규칙 기반의 업무를 AI 에이전트에게 위임하는 방향으로 움직였습니다. 실제로 팀에서는 /automate, /review, /split-to-prs 같은 명령어를 표준화해 사용하고 있는데, 이런 명령어들은 개인이 “이럴 땐 이렇게 물어보면 되더라”는 식으로 쌓아온 노하우를 팀 전체가 공유하는 표준 프로세스로 정형화한 것입니다. 개인의 숙련도에 의존하던 작업이, 팀이라면 누구나 재사용할 수 있는 업무 시스템으로 바뀐 셈입니다. 또한 QMS(품질경영시스템) 문서나 감사 증빙 자료를 업로드·검토·승인하는 과정에도 상태 기반 워크플로우가 도입되어, 담당자가 자료를 올리면 “검토 중 → 승인” 단계를 시스템상에서 추적할 수 있게 되었습니다. 규제 산업 특성상 사람이 최종 승인해야 하는 지점은 남겨두되, 그 앞뒤의 업로드·정리·상태 추적은 자동화한 형태입니다. 가장 많은 조직이 놓치는 지점발표에서 가장 강조된 대목은 “AI 툴만 도입”과 “업무 프로세스 재정의”를 구분한 부분입니다. 대다수 조직이 ChatGPT, Gemini, Copilot 같은 도구를 배포하는 단계에서 멈추지만, 실제 변화를 만드는 조직은 여기서 한 단계 더 나아가 작은 단위로라도 업무 프로세스 자체를 다시 정의합니다. 도구를 얹는 것은 개인의 작업 속도를 조금 높여주지만, 일하는 방식을 바꾸는 것은 팀의 협업 구조와 산출물의 질을 바꿉니다. 황소흠님은 이 차이를 “도구를 얹는 것”과 “일하는 방식을 바꾸는 것”의 차이로 표현합니다. 세 가지 시사점이 사례가 모든 글로벌 조직의 표준이라고 할 수는 없습니다. 다만 AI를 단순한 도구가 아니라 업무 시스템의 일부로 활용할 때 어떤 변화가 가능한지를, 개인 → 팀 → 조직 세 층위로 정리해볼 수 있습니다. 개인: AI는 생산성 도구에서 팀의 인프라로 이동합니다. ChatGPT를 잘 쓰는 사람이 생기는 것과, 팀이 /review, /automate 같은 방식으로 AI 활용법 자체를 표준화하는 것은 다른 일입니다. 팀: 직군의 경계보다 업무의 흐름이 중요해집니다. 디자이너가 코드를 이해하고, 기술 운영팀이 반복 업무를 AI에게 넘기면서, 순차적으로 넘기던 협업이 병렬적으로 진행하는 협업으로 바뀝니다. 조직: 결국 필요한 건 ‘AI를 잘 쓰는 사람’보다 ‘AI와 함께 일하는 방식을 설계할 수 있는 사람’입니다. 도구를 얹는 것과 일하는 방식을 바꾸는 것의 차이는, 결국 이 설계를 누가 할 수 있느냐에서 갈립니다. 본 정리본은 Flexwork x 기고만장 웨비나 1부, 황소흠 Product Designer 발표 자료를 바탕으로 작성되었습니다. 사례로 소개된 영국 메드테크 기업은 발표에 인용된 해외 기업 사례이며, 저작권은 원 발표자 및 해당 기업에 있습니다.
플렉스웍
어떻게든 업무가 이어지도록 돕는 AI 인수인계서
어떻게든 업무가 이어지도록 돕는 AI 인수인계서AI와 오래 이야기하다 보면 어느 순간 답이 엉뚱한 방향으로 흐를 때가 있습니다. 앞에서 하지 않기로 한 방법을 다시 말하거나, 이미 끝낸 일을 제안하기도 합니다. 사람도 비슷합니다. 한참 A를 이야기하다가 갑자기 B와 C까지 한꺼번에 이야기하면 중요한 내용을 놓치기 쉽습니다. AI도 한 대화에서 글쓰기, 자료 조사, 일정 정리처럼 서로 다른 일을 계속 맡으면 지금 가장 중요한 일이 무엇인지 찾기 어려워질 수 있습니다. 이럴 때 필요한 것은 더 긴 대화가 아닙니다. 새로운 대화가 일을 바로 이어받을 수 있게 도와주는 AI용 인수인계 문서입니다. 좋은 인수인계는 다음 일을 바로 이어갈 수 있도록, 결정한 내용과 남은 일을 분명하게 정리하는 것입니다. 저는 세 종류의 문서로 일을 이어갑니다저는 AI와 함께 개인 프로젝트를 장기간 진행하고 있습니다. 한 대화에서 모든 작업을 끝낼 수 없기 때문에, 새 채팅 세션이나 다른 AI 에이전트가 일을 이어받을 수 있도록 세 종류의 문서를 사용합니다. 첫째, 로드맵에는 전체 작업의 현재 위치를 적습니다. 무엇을 끝냈고, 무엇이 남았으며, 다음에 어떤 일을 해야 하는지 한곳에서 확인할 수 있습니다. 둘째, 설계 문서에는 무엇을 왜 그렇게 만들기로 했는지 적습니다. 나중에 다른 AI가 작업하더라도 이미 검토한 선택을 이유 없이 되돌리지 않도록 돕습니다. 셋째, 구현 계획 문서에는 어떤 순서로 만들고 어떻게 확인할지 적습니다. 큰 작업을 작은 단계로 나누고, 각 단계가 끝났다고 판단할 기준도 함께 남깁니다. 이 문서들은 제가 사용하는 Superpowers라는 AI 스킬의 도움을 받아 작성하고 있습니다. 또 로드맵을 확인하고 갱신하는 과정을 일정하게 만들기 위해 별도의 roadmap 스킬도 시험하고 있습니다. 아직 테스트 단계이지만, 인수인계 문서는 한 번 쓰고 보관하는 것보다 일이 바뀔 때마다 현재 상태를 고치는 것이 중요하다는 점을 확인하고 있습니다. 같은 작업의 설계 문서와 구현 계획 문서를 함께 관리합니다. 로드맵에서 완료한 작업과 현재 위치, 다음 작업을 함께 확인합니다. 이 구조를 여행에 비유할 수도 있습니다. 로드맵은 지금 있는 곳과 다음 목적지를 알려주는 지도입니다. 설계 문서는 그 목적지를 고른 이유를 설명합니다. 구현 계획 문서는 그곳까지 어떤 순서로 갈지 알려줍니다. AI의 책상도 크기가 정해져 있습니다제가 이렇게 문서를 나눠 쓰는 이유는 AI가 대화 내용을 끝없이 또렷하게 기억할 수 없기 때문입니다. AI가 한 번에 펼쳐 놓고 참고할 수 있는 정보의 양에도 범위가 있습니다. 이를 context size라는 말로 표현하기도 합니다. 저는 이것을 책상에 비유합니다. 책상 위에 한 가지 일에 필요한 자료만 올려두면 무엇을 해야 하는지 쉽게 찾을 수 있습니다. 반대로 여러 일의 메모와 자료를 모두 쌓아두면, 꼭 필요한 자료가 어디 있는지 찾기 어려워집니다. AI와의 대화도 같습니다. 대화가 길어질수록 처음에 정한 목표와 중요한 조건이 수많은 질문과 중간 결과 사이에 묻혀 방향을 잃을 수 있습니다. 그래서 저는 일이 크게 달라지거나 대화가 너무 길어지면 새 대화를 시작합니다. 대신 지난 대화 전체를 복사하지 않고, 다음 작업에 꼭 필요한 내용만 문서로 넘깁니다. AI도 지금 필요한 자료를 찾기 쉬워야 합니다. AI가 문서를 읽을 때는 정리 방식이 조금 달라집니다책상 위에 지금 필요한 자료만 남겨두는 것처럼, 새 대화를 시작할 때도 AI가 다음 작업에 사용할 내용을 골라서 보여줘야 합니다. 사람이 읽는 인수인계 문서를 그대로 활용할 수도 있지만, AI가 바로 이해하고 작업하려면 내용을 조금 다르게 정리하는 편이 좋습니다. 사람이 읽는 인수인계 문서는 길지 않고 전체 흐름을 쉽게 파악할 수 있어야 합니다. 중요한 배경과 결정, 다음 할 일을 중심으로 구성하면 좋습니다. 문서에 없는 내용은 동료에게 물어볼 수도 있습니다. 그러나 AI가 읽을 내용은 조금 다르게 정리합니다. 보기 좋은 보고서처럼 문장을 매끄럽게 다듬는 것보다, 다음 작업에 필요한 사실을 빠짐없이 적는 일이 더 중요합니다. 목표, 결정한 내용, 그렇게 결정한 이유, 하지 않을 일, 참고할 자료, 남은 일과 확인 방법을 글머리표로 나누어 적을 수 있습니다. AI는 문서에 없는 기업 사정이나 개별적인 경험을 주변 사람에게 물어볼 수 없습니다. 그래서 사람에게는 당연해 보이는 내용도 AI가 읽는 부분에는 직접 적어주는 편이 안전합니다. 같은 문서라도 사람은 빠르게 읽을 수 있어야 하고, AI가 읽을 때는 다음 작업에 필요한 정보가 명료해야 합니다. 누구나 간단하게 시작할 수 있습니다처음부터 여러 문서를 만들 필요는 없습니다. 아래 내용을 메모장이나 문서 도구에 적는 것만으로도 시작할 수 있습니다. 꼭 이 양식을 그대로 따르거나 별도의 문서를 만들 필요는 없습니다. 새 대화를 시작하는 프롬프트에 위 내용이 들어 있다면 같은 방식으로 활용할 수 있습니다. 새 대화를 시작할 때 이 문서나 프롬프트를 먼저 보여주고, AI에게 현재 상태를 짧게 정리해 달라고 요청해 보세요. 잘못 이해한 부분이 있다면 작업을 시작하기 전에 고칠 수 있습니다. 작업이 끝난 뒤에는 완료한 일과 다음 할 일을 다시 적습니다. 중요한 것은 모든 대화를 남기는 일이 아닙니다. 다음 작업에 필요한 결정과 이유가 빠지지 않았는지 확인하는 일입니다. 대화가 끝나도 업무의 흐름은 남아야 합니다AI용 인수인계 문서는 긴 대화를 줄여 놓은 요약문만은 아닙니다. 담당자가 바뀌거나, 새 채팅 세션을 열거나, 다른 AI 에이전트를 사용하더라도 현재 위치와 결정한 이유를 찾을 수 있게 해주는 공통 기록입니다. 좋은 문서가 있다고 모든 사람과 AI가 똑같은 답을 내는 것은 아닙니다. 하지만 이미 끝낸 논의를 되풀이하거나, 마친 일을 처음부터 다시 시작하는 일은 줄일 수 있습니다. 대화는 끝나도 업무의 흐름까지 끝날 필요는 없습니다. 누가 다음 작업을 맡든, 어떤 AI와 새 대화를 시작하든, 잘 정리된 인수인계 문서가 있다면 우리는 지난 대화를 되풀이하지 않고 다음 단계에서 다시 시작할 수 있습니다.
 정상운
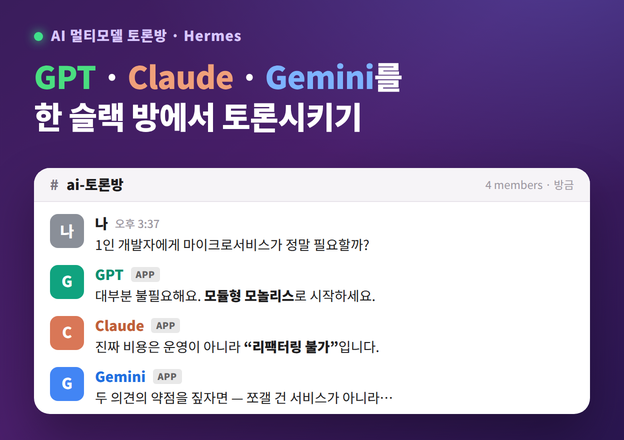
Hermes 멀티 모델 토론 봇 만들기
목표: Slack 한 스레드 안에서 나 + 세 개의 AI 봇(각각 다른 모델)이 함께 토론하기. @hermes → GPT-5.6 (기본, 이미 있음) @hermes-claude → Claude Opus 4.8 (새로 추가) @hermes-gemini → Gemini Flash (새로 추가) 커스텀 코드 없이 Hermes 프로필 기능만으로 만듭니다. 어떻게 작동하나요? Hermes의 프로필(profile) 은 "독립된 직원"이에요. 프로필마다 다른 모델, 다른 Slack 봇, 다른 기억을 가질 수 있어요. 프로필 = 서로 다른 참가자/직원 각 프로필은 자기만의 Slack 봇으로 워크스페이스에 등장 사용자가 스레드에서 @hermes-claude 어떻게 생각해? 하고 부르면 그 모델이 답하고, 각 봇은 스레드 내용을 읽어서 앞선 발언에 반박할 수 있어요 사용자가 사회자처럼 진행 핵심 규칙: 프로필마다 Slack 봇 토큰이 따로 있어야 해요. 그래서 봇마다 Slack 앱을 새로 만듭니다. 준비물이미 완성된 24/7 Hermes 서버 (DigitalOcean) : 설치 방법은 지난 블로그 글을 참고하세요 Claude와 Gemini에 접근할 방법 ← 아래 0단계에서 결정 Slack 앱 2개 새로 만들 시간 (봇당 약 5분) 0단계. 모델 접근 방법 정하기 (가장 중요)지금 서버는 OpenAI(gpt-5.6)만 연결돼 있어요. Claude와 Gemini를 부르려면 접근 수단이 필요해요. 두 가지 방법: 방법 A. OpenRouter 키 하나 (추천 ⭐)https://openrouter.ai 가입 → Keys 메뉴에서 키 1개 발급 (sk-or-...) 이 키 하나로 GPT·Claude·Gemini 전부 사용 가능 크레딧을 미리 충전(예: $10)해두면 사용한 만큼 차감 가장 간단해서 이 가이드는 A 기준으로 설명해요 방법 B. 각 사 키 따로Claude용: https://console.anthropic.com 에서 Anthropic API 키 Gemini용: https://aistudio.google.com 에서 Google AI 키 프로필마다 해당 키를 넣음 (더 번거롭지만 각 사 직접 과금) 아래 단계는 방법 A(OpenRouter) 기준입니다. 방법 B도 "제공자 선택" 부분만 다르고 나머지는 동일해요. 1단계. 프로필 2개 만들기서버 터미널(ssh root@서버IP)에서: hermes profile create hermes-claude hermes profile create hermes-gemini 확인: hermes profile list hermes-claude, hermes-gemini가 보이면 성공. 앞으로 특정 프로필에 명령하려면 hermes -p 프로필이름 ... 형태를 써요.예: hermes -p hermes-claude model 2단계. 각 프로필에 모델 연결하기hermes-claude 프로필 → Claude Opus 4.8hermes -p hermes-claude model 제공자 목록에서 OpenRouter 선택 OpenRouter 키(sk-or-...) 입력 모델 선택에서 Claude Opus 계열 선택 (예: anthropic/claude-opus-4.8) hermes-gemini 프로필 → Geminihermes -p hermes-gemini model 제공자 OpenRouter 선택 같은 OpenRouter 키 입력 모델 선택에서 Gemini 최신 계열 선택 (예: google/gemini-2.5-pro) 각 프로필에서 "Default model set to..." 가 뜨면 성공. 정확한 모델 ID는 시점에 따라 바뀔 수 있어요. hermes -p ... model 의 목록에서 골라 쓰면 항상 최신 걸 안전하게 선택할 수 있어요. 3단계. Slack 봇 2개 새로 만들기기본 봇을 만들 때 했던 그 절차를, 봇마다 한 번씩 반복해요. (이전 포스팅 Slack 연동 가이드의 5부 참고) 3-1. hermes-claude용 Slack 앱서버에서 매니페스트 생성: hermes -p hermes-claude slack manifest --agent-view --write 출력된 JSON 복사 cat .hermes/profiles/hermes-claude/slack-manifest.json * 참고: 출력된 slack-manifest.json 에서 Display Name 과 Bot Name 을 "Hermes" 에서 "Hermes-Claude"로 바꿔주세요. https://api.slack.com/apps → Create New App → From an app manifest 워크스페이스 선택 → JSON 붙여넣기 → Create 앱 이름을 hermes-claude 로 알아보기 쉽게 설정 (Basic Information에서 표시 이름 변경 가능) Socket Mode ON → 앱 레벨 토큰(xapp-) 발급·복사 Event Subscriptions ON → app_mention, message.channels 등 확인 Install App → Install to Workspace → 봇 토큰(xoxb-) 복사 3-2. hermes-gemini용 Slack 앱위 3-1을 똑같이 반복하되, -p hermes-gemini 로: hermes -p hermes-gemini slack manifest --agent-view --write 출력된 JSON 복사: cat .hermes/profiles/hermes-gemini/slack-manifest.json * 참고: 출력된 slack-manifest.json 에서 Display Name 과 Bot Name 을 "Hermes" 에서 "Hermes-Gemini"로 바꿔주세요.→ 새 Slack 앱 생성, 이름 hermes-gemini, 토큰 두 개(xapp-, xoxb-) 확보 결과적으로 봇마다 토큰 2개씩, 총 4개의 토큰이 생겨요. 어느 봇 건지 헷갈리지 않게 메모해두세요. 4단계. 각 프로필에 Slack 토큰 연결hermes -p hermes-claude gateway setupSlack 선택 → hermes-claude용 xoxb-, xapp- 입력 hermes -p hermes-gemini gateway setupSlack 선택 → hermes-gemini용 xoxb-, xapp- 입력 ⚠️ 중요 — "Choose how the gateway should run in the background" 화면이 뜨면 Skip service install for now를 선택하세요.새 프로필은 각자 서비스를 설치하면 안 돼요. 마지막 5단계에서 기본 프로필의 멀티플렉스 서비스 하나가 모든 프로필을 대신 돌립니다. 프로필마다 서비스를 따로 깔면 충돌이 나고 1GB 서버에 부담이 커져요.(User service / System service / Skip service install for now 중 → 방향키로 Skip 선택 → ENTER) 5단계. 한꺼번에 실행하기 (멀티플렉스)1GB 서버라 프로세스를 여러 개 띄우면 무거워요. 하나의 프로세스가 모든 프로필을 담당하게 설정해요. ⚠️ 중요 — 반드시 환경변수 방식으로 켜세요.hermes config set gateway.multiplex_profiles true 는 버전에 따라 "not a recognized config key" 경고가 뜨며 실제로 안 켜질 수 있어요. 가장 확실한 방법은 .env에 환경변수를 넣는 거예요 (우선순위: 환경변수 > config.yaml > 꺼짐): echo 'GATEWAY_MULTIPLEX_PROFILES=true' >> ~/.hermes/.env sudo hermes gateway restart --system 확인 — 로그에서 여러 봇이 각각 연결되는지 봅니다: tail -n 40 ~/.hermes/logs/gateway.log 아래처럼 프로필마다 Authenticated as @... 가 뜨고 Gateway running with N platform(s) 가 나오면 성공: ✓ slack connected (default, @hermes) ✓ slack connected (profile: hermes-claude, @hermes_claude) ✓ slack connected (profile: hermes-gemini, @hermesgemini) Gateway running with 3 platform(s) 새 프로필들은 별도 서비스로 install 하지 마세요(4단계에서 "Skip" 선택). 멀티플렉스가 켜지면 기본 서비스 하나가 모든 프로필을 알아서 챙깁니다.멀티플렉스는 호스트의 모든 프로필을 자동 포함해요. 안 쓰는 프로필이 있으면 같이 켜지니, 특정 프로필만 돌리려면 config.yaml의 gateway.multiplex_profile_allowlist로 제한할 수 있어요. 6단계. Slack에서 토론시키기Slack에서 토론할 채널을 하나 정하고, 세 봇을 모두 초대: /invite @hermes /invite @hermes-claude /invite @hermes-gemini 이제 토론 시작! 예시 흐름: 나: @hermes 이 주제로 토론을 시작하자. 주제: "1인 개발자에게 마이크로서비스가 과연 필요한가?" 네 입장은? @hermes (GPT): (입장 A 제시) 나: @hermes-claude GPT 의견 봤지? 너는 어떻게 생각해? @hermes-claude (Opus): (반박 또는 보완) 나: @hermes-gemini 두 의견의 약점을 짚어줘 @hermes-gemini (Gemini): (제3의 관점) 나: @hermes 셋의 의견을 종합해서 결론 내줘 각 봇은 스레드/채널 내용을 읽으니 서로의 발언에 반응해요. 사용자가 사회자처럼 순서를 정하며 진행하면 됩니다. 팁: 각 프로필의 성격을 SOUL.md로 다르게 줄 수 있어요. 예를 들어 hermes-claude는 "신중한 비판자", hermes-gemini는 "창의적 발상가"처럼. 서버에서 ~/.hermes/profiles/hermes-claude/SOUL.md 를 편집하면 돼요. ⭐ 꼭 해두기 — 부른 봇만 답하게 잠그기 (SLACK_STRICT_MENTION)기본 설정에선, 한 번 스레드에 참여한 봇은 그 스레드에서 멘션 없이도 계속 끼어들어요(auto-follow). 그러면 Claude를 불렀는데 기본 봇이 "이건 Claude한테 묻는 거니 난 빠질게" 같은 불필요한 답을 하거나, 여러 봇이 동시에 튀어나와요. 각 프로필의 .env에 아래를 넣으면 정확히 @멘션된 봇만 답해요 (토론 진행이 깔끔해짐): echo 'SLACK_STRICT_MENTION=true' >> ~/.hermes/.env echo 'SLACK_STRICT_MENTION=true' >> ~/.hermes/profiles/hermes-claude/.env echo 'SLACK_STRICT_MENTION=true' >> ~/.hermes/profiles/hermes-gemini/.env sudo hermes gateway restart --system 팁 — 봇 이름을 확실히 다르게봇 이름이 다 "Hermes~"로 시작하면 Slack 멘션 자동완성이 헷갈려요. 각 Slack 앱의 Basic Information / App Home에서 표시 이름을 GPT / Claude / Gemini 처럼 구분되게 바꾸면, @Claude 어때? 로 원하는 봇만 정확히 부를 수 있어요. 문제 해결특정 봇이 대답을 안 해요hermes -p hermes-claude gateway status tail -n 30 ~/.hermes/logs/gateway.log Provider auth failed → 그 프로필의 모델 연결이 안 된 것. hermes -p 프로필 model 다시 실행(유효한 키 + 모델 선택) → sudo hermes gateway restart --system Slack 관련 오류 → 토큰 재확인 한 봇을 불렀는데 다른 봇도 끼어들어요 / "저는 답변 보류할게요" 가 떠요→ 스레드 안에서 auto-follow가 작동한 거예요. 각 프로필 .env에 SLACK_STRICT_MENTION=true를 넣으세요(위 "부른 봇만 답하게 잠그기" 참고). 그러면 @멘션된 봇만 답합니다. "same bot token" 충돌 에러→ 두 프로필이 같은 Slack 토큰을 쓴 거예요. 봇마다 다른 Slack 앱/토큰이어야 해요. 3단계를 봇별로 따로 했는지 확인. 로그에 invalid_auth / slack failed to connect (profile: ...)→ 그 프로필의 Slack 봇 토큰이 틀렸다는 뜻이에요. 흔한 원인: 토큰을 잘못/일부만 붙여넣음 (또는 xoxb-와 xapp-를 바꿔 넣음) Slack 앱을 워크스페이스에 Install 안 함 → 봇 토큰이 활성화 안 됨 다른 앱의 토큰을 넣음 해결: 해당 앱에서 Install to Workspace 확인 → xoxb- 다시 복사 → hermes -p 프로필 gateway setup 으로 재입력 → sudo hermes gateway restart --system. 로그에 Authenticated as @... 가 뜨면 OK. 봇이 서로의 말을 못 알아듣는 것 같아요→ 각 봇 Slack 앱의 Event Subscriptions에 message.channels가 있고, 봇이 그 채널에 초대돼 있는지 확인. 그래야 스레드 내용을 읽어요. 서버가 느려지거나 멈춰요 (메모리 부족)→ 1GB 서버에서 세 모델이 동시에 무거운 답을 하면 빠듯할 수 있어요. 멀티플렉스(5단계)를 켰는지 확인하고, 그래도 부족하면 서버를 월 $12(2GB)로 올리는 걸 고려하세요. (DigitalOcean에서 Resize) 한 장 요약OpenRouter 키 발급 (GPT·Claude·Gemini 한 키로 접근) hermes profile create hermes-claude / hermes-gemini 각 프로필에 hermes -p ... model 로 Claude / Gemini 연결 Slack 앱 2개 새로 생성 → 봇 토큰(xoxb-,xapp-)씩 확보 hermes -p ... gateway setup 으로 각 프로필에 Slack 연결 .env에 GATEWAY_MULTIPLEX_PROFILES=true 추가 + 재시작 → 세 봇 동시 가동 Slack 채널에 세 봇 초대 → 사회자처럼 토론 진행 완성! 이제 GPT·Claude·Gemini와 함께 토론하는 Slack 방이 생겼어요. 🎭
 송경연
AI시대에 살아남는 엔지니어 1편: AI한테 "이 레거시 코드 파악해줘" 시켜봤다 — LLM이 잘하는 것과 절대 못 하는 것
"최신 ChatGPT나 Claude, Cursor에 수천 줄짜리 레거시 파일 하나 던져주고 '이 코드 파악해서 요약해줘' 하면 다 해결되는 것 아닌가요?" AI 도구가 급격히 발전하면서 많은 개발자와 경영진이 "이제 레거시 코드 분석도 AI가 알아서 다 해주는 시대가 왔다"고 오해합니다. 하지만 문서도 없고, 주석도 없고, 10년 넘게 비즈니스 로직이 기형적으로 꼬인 스파게티 레거시 코드를 LLM(대형 언어 모델)에 실제로 던져보면 기대와는 전혀 다른 아찔한 결과를 마주하게 됩니다. AI 도구를 활용해 레거시 시스템을 파악할 때 LLM이 압도적으로 잘하는 영역과 AI를 맹신했다간 시스템을 터뜨리게 되는 '절대 못 하는 영역'의 경계를 명확히 정리합니다. 1. LLM이 압도적으로 '잘하는' 영역 (AI를 200% 활용하는 법)AI는 문맥이 단절된 파편화된 코드를 분석하거나 난독화된 구문을 해독하는 데 엄청난 생산성을 발휘합니다. 난독화/스파게티 구문 해석 및 리팩토링 제안: 변수명이 $a, $tmp2처럼 엉망이거나, 깊은 삼중 if문으로 꼬여있는 100줄짜리 함수를 던져주면 "이 함수는 유저의 결제 상태값을 검증하는 구문입니다"라며 깔끔한 가독성 높은 코드로 재작성해 줍니다. 구형 프레임워크/언어 문법 현대화 번역: PHP 5.x의 구형 DB 함수나 obsolete된 라이브러리 구문을 최신 PHP 8.x/Node.js 문법으로 변환할 때, 단순 문법적 치환(Syntax Migration)은 AI가 인간보다 10배 이상 빠릅니다. 단위 테스트(Unit Test) 보일러플레이트 생성: 분석한 함수의 입력값과 출력값을 기반으로 Edge Case(예외 상황)를 고려한 테스트 코드를 빠르게 작성해 줍니다. 2. LLM이 '절대 못 하는' 영역 (AI의 치명적 한계 3가지)반면, 레거시 시스템의 핵심인 '숨겨진 맥락'과 '비즈니스의 숨겨진 룰' 앞에서 AI는 무력해집니다. ① '숨은 비즈니스 로직(Implicit Rules)' 파악 불가 // 레거시 코드 속 이상한 예외 처리 if ($user_id == 8492 && $total_price > 100000) { $discount_rate = 0.15; }AI에게 이 코드를 물어보면 "특정 유저 ID와 금액 조건에 따른 할인 로직입니다"라고 답합니다.하지만 이 코드가 "5년 전 VIP 고객이었던 특정 기업과의 구두 계약 때문에 임시로 넣어둔 예외 로직"이라는 비즈니스 배경(Domain Knowledge)은 AI가 절대 알 수 없습니다. AI 말만 믿고 이 코드를 "불필요한 하드코딩"이라며 지웠다간 대형 비즈니스 클레임이 터집니다. ② 시스템 전체의 '숨겨진 사이드 이펙트(Side Effect)' 예측 불가 레거시 시스템은 DB Trigger, 외부 API, 크론잡(Cronjob), 공통 세션 등이 얽혀있는 경우가 많습니다. AI는 자신이 텍스트로 입력받은 파일 범위 내에서만 사고하므로, "이 파일의 A 함수를 고쳤을 때 새벽 3시에 도는 정산 크론잡이 터진다"는 거시적인 파급 효과를 예측하지 못합니다. ③ '존재하지 않는 로직'을 진실처럼 말하는 환각(Hallucination) 레거시 코드가 너무 복잡하거나 세션/글로벌 변수에 의존할 때, LLM은 자기가 모른다는 사실을 인정하는 대신 그럴듯한 가짜 동작 원리를 만들어내면서 설명(Hallucination)합니다. AI의 거짓말을 믿고 리팩토링을 진행했다가 런타임 에러를 맞닥뜨리는 경우가 수두룩합니다. 3. 실무자를 위한 'AI 기반 레거시 파악' 올바른 워크플로우AI는 '코드 단위의 번역기/요약기'로만 사용한다: 전체 아키텍처나 비즈니스 판단을 맡기지 말고, 특정 메서드나 쿼리의 의도를 파악하는 보조 도구로만 제한합니다. "왜 이 코드가 작성되었는가?"는 사람(기획자, DB 기록, Git History)이 찾는다: 코드의 '형태'는 AI가 보고, 코드 뒤에 숨은 '이유'는 엔지니어가 검증해야 합니다. AI가 작성해 준 분석을 토대로 '검증용 테스트'를 먼저 돌린다: AI의 요약 답변을 100% 믿지 말고, 반드시 실제 입력/출력값 테스트를 거쳐 검증합니다. 마무리하며AI는 레거시 현대화의 훌륭한 '보조 항해사(Copilot)'는 될 수 있지만, 배의 키를 잡는 '선장(Captain)'이 될 수는 없습니다. 결국 AI가 읽어내지 못하는 비즈니스의 역사, 의사결정의 배경, 시스템의 전체 맥락을 짚어내는 것은 숙련된 베테랑 엔지니어의 경험과 직관입니다. AI 도구를 현명하게 도구로 활용할 때, 레거시 분석 속도는 비로소 안전하게 5배 이상 빨라질 수 있습니다.
 gwihyeon jo
